الذكاء الاصطناعي للمبتدئيندليل
كيف تختار نموذج ذكاء اصطناعي: السياق، المخرجات، السرعة، السعر
اختر نموذجًا للمحادثة أو البرمجة أو وكيل بأربعة أرقام: نافذة السياق، الحد الأقصى للمخرجات، السرعة والسعر. أمثلة محلولة وجدول تكلفة حي.
في هذه الصفحة
قائمة نماذج بأربعين اسمًا، ومهمة موصوفة في جملة واحدة، ولا رابط واضح بين الاثنين. إليك الإجابة المختصرة: تحقق من أربعة أرقام، بهذا الترتيب. نافذة السياق والحد الأقصى للمخرجات يحددان ما إذا كان النموذج قادرًا على أداء مهمتك أصلًا. السرعة والسعر يحددان مدى متعة الاستخدام وتكلفته. السياق وحد المخرجات والسعر مدرجة في صفحة النماذج وفي جدول الأسعار؛ أما السرعة فتقيسها بنفسك في حوالي دقيقة، والسكربت أدناه.
الأرقام الأربعة بكلمات بسيطة#
تخيل النموذج كزميل على مكتب. نافذة السياق هي حجم المكتب: كل ما يجب أن يكون أمامه في وقت واحد. الحد الأقصى للمخرجات هو طول ما يمكنه قوله في مرة واحدة. السرعة هي مدى سرعة بدء الإجابة. السعر هو أجرته بالساعة. أربعة مصطلحات، وستصادفها جميعًا في كل وثيقة API:
بطاقات تعليمية
كلمات ستقابلها في كل قائمة نماذج
اضغط على البطاقة لقلبها
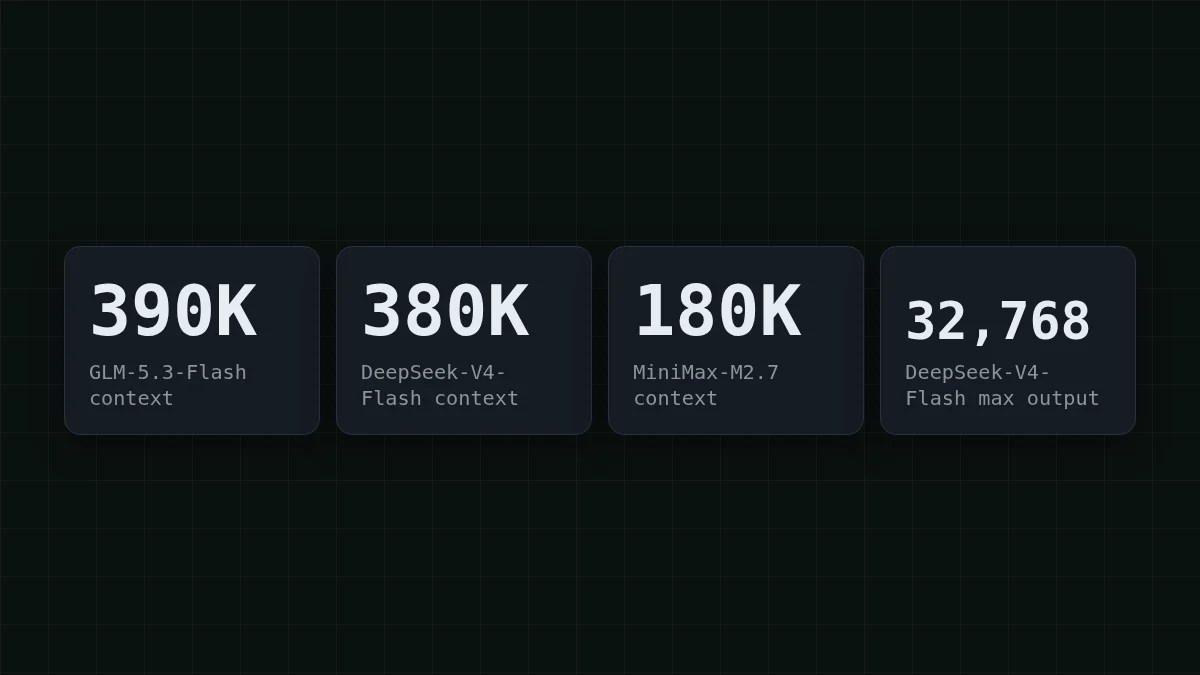
لتوضيح ذلك، إليك أول رقمين للنماذج الثلاثة في كتالوج CheapTokens، من مرجع نماذج CheapTokens (27 أكتوبر 2026): GLM-5.3-Flash لديه سياق 390K ويجيب حتى 8,192 توكن؛ DeepSeek-V4-Flash (إصدار 0731) لديه 380K ويجيب حتى 32,768 توكن؛ MiniMax-M2.7 لديه 180K ويجيب حتى 8,192 توكن.
السياق: هل سيتسع كل ما ترسله؟#
لنفترض أن مساعد البرمجة الخاص بك يفتح 12 ملفًا بحوالي 3,000 توكن لكل منها، ثم يضيف سؤالك وملاحظاته الخاصة. 12 × 3,000 = 36,000 توكن. حتى أصغر نافذة أعلاه، 180K، تستوعب ذلك مع مساحة كبيرة. الملف الضخم الواحد أو تفريغ مستودع كامل هو حيث تبدأ النافذة في الأهمية.
المحادثات والوكلاء أكثر تعقيدًا، لأن API يعيد إرسال السجل كاملًا مع كل استدعاء. خذ وكيلًا ينفذ 20 خطوة، وكل خطوة تضيف حوالي 2,000 توكن من مخرجات الأدوات والرد (افتراض لهذا المثال). الخطوة 1 ترسل 2,000 توكن، الخطوة 2 ترسل 4,000، الخطوة 20 ترسل 40,000. خلال التشغيل بأكمله يرسل 2,000 × 210 = 420,000 توكن، حيث 210 هو 1 + 2 + … + 20.
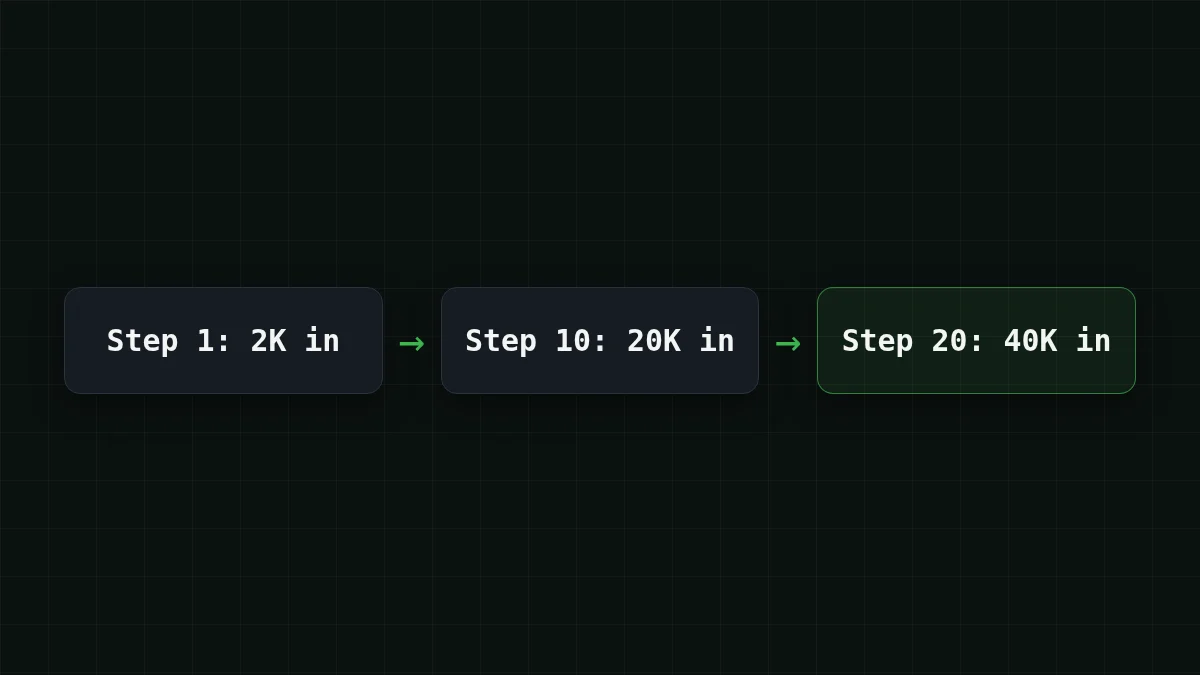
سؤالان مختلفان يختبئان هنا. نافذة السياق تهتم فقط بأكبر طلب واحد: 40,000 توكن عند الخطوة 20، وهو ما يستوعبه كل نموذج في الكتالوج بسهولة. الفاتورة تهتم بالإجمالي، 420,000 توكن. احتفظ بكليهما في ذهنك، ولن تختار نموذجًا للسبب الخاطئ.
طول المخرجات: الحد الذي يقطع الإجابات#
حد المخرجات هو سقف لرد واحد، ويسهل نسيانه حتى تتوقف إجابة في منتصف الجملة. قاعدة تقريبية للإنجليزية: التوكن الواحد حوالي ثلاثة أرباع كلمة. تطلب تقريرًا من 6000 كلمة: 6000 / 0.75 = 8000 توكن. هذا بالكاد يتسع تحت 8,192. اطلب 7,000 كلمة وسينتهي النص في منتصف فقرة.
مع سقف 32,768 توكن، تعطي نفس الحسابات 24576 كلمة في إجابة واحدة (32768 × 0.75 = 24576)، لذا يتسع الكود المولد والتقارير الطويلة ومسودات فصول كاملة في رد واحد. عندما يتم قطع رد فعلًا، يخبرك API: finish_reason يعود كـ length (لماذا يحدث ذلك وكيفية إصلاحه).
فحص سريع
تطلب من نموذج بحد مخرجات 8,192 توكن تقريرًا من 12,000 كلمة. ماذا تحصل؟
إظهار الإجابة
الإجابة: تقرير يتوقف في المنتصف، مع تعيين finish_reason إلى length
12,000 كلمة حوالي 16,000 توكن، ضعف السقف. يكتب النموذج حتى يصل إلى السقف ويتوقف، ويضع API علامة على الرد بـ finish_.
السرعة: الرقم الوحيد الذي تقيسه بنفسك#
السرعة هي في الحقيقة رقمان: كم من الوقت حتى ظهور النص الأول، ومدى سرعة تدفق الباقي. كلاهما يتغير مع الحمل وطول المطالبة ووقت اليوم، لذا فإن رقمًا منسوخًا من جدول هو دليل ضعيف. قِسها على مطالبتك الخاصة. يستغرق هذا دقيقة ويستخدم بضعة توكنات (المفتاح يأتي من متغير بيئة؛ راجع الوثائق لإنشاء واحد):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
تحصل على سطر واحد: first text after <N>s, finished after <M>s. استبدل معرف النموذج بـ zai- أو MiniMaxAI/، شغّل كلًا منهما بضع مرات، وستحصل على مقارنة سرعة لمطالبتك. هل يهم؟ للمحادثة المباشرة، نعم: يلاحظ الناس التوقف قبل الكلمة الأولى. لدفعة ملخصات ليلية، لا أحد يراقب، وتنخفض السرعة إلى أسفل قائمتك.
السعر: اجمع الإدخال والإخراج معًا#
الأسعار مقتبسة لكل مليون توكن، لكنك تدفع لكل طلب، والطلب له جانب إدخال وجانب إخراج. لذا قارن النماذج على عبء عمل، وليس على عمودين. لنفترض أن بوت الدعم الخاص بك يتعامل مع 1,000 تذكرة يوميًا، كل منها حوالي 300 توكن إدخال و150 إخراج (افتراض؛ استبدله بأرقامك). الجدول حي ويعيد الحساب من الأسعار الحالية:
| النموذج | الإدخال $/1M | الإخراج $/1M | لكل طلب | 1,000 طلبات | OpenRouter، 1,000 طلبات |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 رمز إدخال و150 رمز إخراج لكل طلب. الأسعار لكل مليون رمز حالية وتتغير مع تعريفاتنا؛ يعرض عمود OpenRouter أسعارًا مرجعية لنفس حجم العمل.
اقرأ الإجمالي، وليس الأعمدة. في الإجمالي، مع احتساب الإدخال والإخراج معًا، يخرج كل من الثلاثة أرخص من سعر OpenRouter المرجعي في عمود OpenRouter في ذلك الجدول.
وهنا يعض الوكلاء. تشغيل 20 خطوة من قسم السياق يرسل 420,000 توكن إدخال ويكتب ربما 4,000 إخراج (200 لكل خطوة، مرة أخرى افتراض). على DeepSeek-V4-Flash يكلف تشغيل واحد كهذا $0.0067. خمسة تشغيلات في اليوم؟ حرك المنزلقات وراقب النماذج الثلاثة:
حاسبة التكلفة
يوم من عمل الوكيل: خمس مهام من 20 خطوة
رموز الإدخال لكل طلب: 21,000 · رموز الإخراج لكل طلب: 200 · الطلبات يوميًا: 100
| النموذج | يوميًا | شهريًا |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
تبقى أسعار النماذج كما هي في أي ساعة من اليوم، لذا فإن حسابًا تجريه الآن يظل صالحًا للدفعة المسائية أيضًا. لتذكير حول سبب كون توكنات الإخراج عادة أغلى من الإدخال، راجع توكنات الإدخال والإخراج.
اختر نموذجًا حسب المهمة#
ابدأ من المهمة، وابحث عن الرقم الذي يعض بأشد قوة، وتحقق من الثلاثة الأخرى بعد ذلك. انقر خلال حالتك الخاصة:
اختر حالتك
أي نموذج لمهمتي؟
اختر خيارًا لعرض الإجابة
بوت دعم بإجابات قصيرة
الأسئلة والأجابات قصيرة، لذا كل نموذج في الكتالوج لديه مساحة فائضة، وعمود السعر يقرر. شغّل تذكرتك النموذجية عبر جدول التكلفة أعلاه وابدأ بـ GLM-5.3-Flash أو MiniMax-M2.7، أيهما يبدو إجماليه أفضل لأرقامك.
مساعد برمجة يقرأ ملفات كثيرة
السياق يأتي أولًا. GLM-5.3-Flash لديه أكبر نافذة من الثلاثة عند 390K، وDeepSeek-V4-Flash لديه 380K. MiniMax-M2.7 عند 180K كافٍ عندما تبقى الملفات التي ترسلها معًا أقل بكثير من ذلك.
وكيل يتكرر عبر خطوات كثيرة
يُعاد إرسال السجل في كل خطوة، لذا ينمو الإجمالي بسرعة. يجمع DeepSeek-V4-Flash سياق 380K مع ما يصل إلى 32,768 توكن إخراج لكل إجابة وسعر واحد في أي ساعة، مما يحافظ على قابلية التنبؤ بالحلقات الطويلة. تحقق من الإجمالي باستخدام الحاسبة أعلاه.
تقارير طويلة وكود مولد
الحد الأقصى للمخرجات يقرر. يكتب DeepSeek-V4-Flash حتى 32,768 توكن لكل إجابة؛ ويكتب GLM-5.3-Flash وMiniMax-M2.7 حتى 8,192، وهو ما يغطي تقريرًا من حوالي 6,000 كلمة.
لا يوجد نموذج واحد يفوز في كل صف، ولهذا يساعد تشغيل نفس العشر مطالبات الحقيقية عبر مرشحين قبل الالتزام. مقارنة GLM مقابل DeepSeek مقابل MiniMax تتعمق في النماذج الثلاثة، وصفحة الأسعار تعرض دائمًا الأرقام الحالية.


