AI入門ガイド
AI モデルの選び方: コンテキスト、出力、速度、価格
チャット、コーディング、エージェント向けに、コンテキストウィンドウ、最大出力、速度、価格の 4 つの数値でモデルを選ぶ。具体例とライブのコスト表付き。
このページの内容
40 のモデル名が並ぶリスト、1 文で説明されたタスク、そして両者をつなぐ明らかな手がかりはない。短い答えを先に言おう。4 つの数値を、この順番で確認する。コンテキストウィンドウと最大出力は、そのモデルがそもそもあなたのタスクを実行できるかを決める。速度と価格は、どれだけ快適で、どれだけ高くつくかを決める。コンテキスト、出力上限、価格はモデルページと料金表に記載されている。速度は自分で 1 分ほどで確認でき、そのスクリプトは下にある。
4 つの数値をやさしい言葉で#
モデルを机に向かう同僚だと考えてみよう。コンテキストウィンドウは机の広さだ。一度に目の前に置いておかなければならないものすべてが載る。最大出力は、一度にどれだけ長く話せるかだ。速度は、どれだけ早く答え始めるかだ。価格は時給だ。4 つの用語で、どの API ドキュメントでも必ず出会う。
フラッシュカード
どのモデルリストでも出会う用語
カードをタップしてめくる
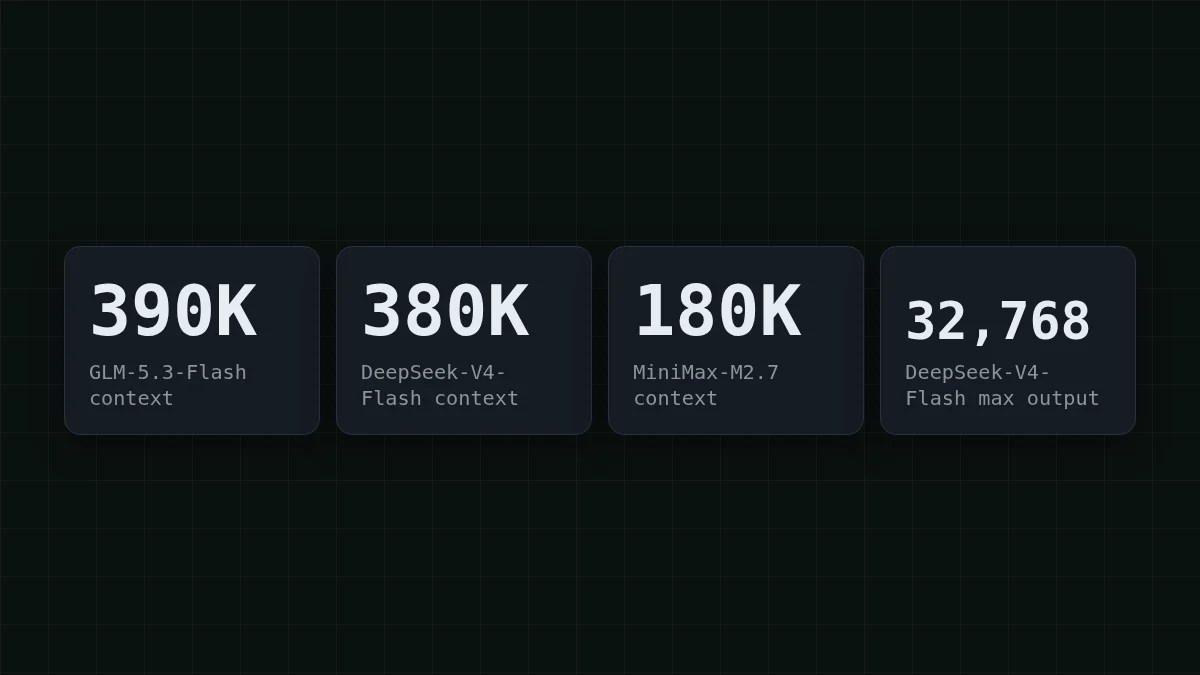
具体例として、CheapTokens カタログにある 3 つのモデルの最初の 2 つの数値を、CheapTokens モデルリファレンス(2026 年 10 月 27 日)から挙げる。GLM-5.3-Flash は 390K のコンテキストを持ち、最大 8,192 トークンまで回答する。DeepSeek-V4-Flash(リリース 0731)は 380K で、最大 32,768 トークンまで回答する。MiniMax-M2.7 は 180K で、最大 8,192 トークンまで回答する。
コンテキスト: 送るものすべてが収まるか?#
あなたのコーディングアシスタントが約 3,000 トークンのファイルを 12 個開き、そこにあなたの質問と自身のメモを加えるとしよう。12 × 3,000 = 36,000 トークン。上記の最小のウィンドウである 180K でも、余裕を持って収まる。1 つの巨大なファイルやリポジトリ全体のダンプになると、ウィンドウが重要になり始める。
チャットとエージェントはもっと厄介だ。API は呼び出しごとに履歴全体を再送信する。20 ステップ実行するエージェントを考えよう。各ステップでツール出力と返信が約 2,000 トークン追加されるとする(この例での仮定)。ステップ 1 は 2,000 トークンを送信し、ステップ 2 は 4,000、ステップ 20 は 40,000 を送信する。実行全体では 2,000 × 210 = 420,000 トークンを送信する。ここで 210 は 1 + 2 + … + 20 だ。
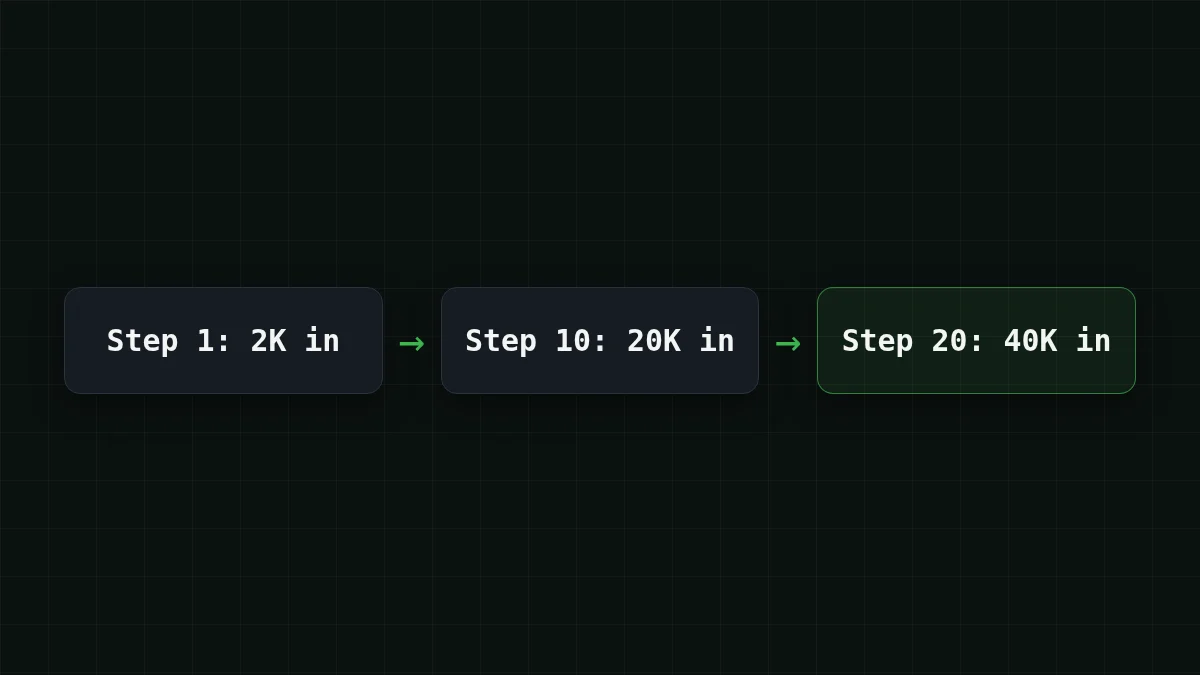
ここには 2 つの異なる問いが隠れている。コンテキストウィンドウは最大の単一リクエストだけを見る。ステップ 20 の 40,000 トークンで、カタログのどのモデルでも簡単に収まる。請求額は合計、つまり 420,000 トークンを見る。両方を頭に入れておけば、間違った理由でモデルを選ぶことはない。
出力長: 回答を途中で切る上限#
出力上限は 1 回の返信の天井であり、回答が文の途中で止まるまで忘れがちだ。英語の目安として、1 トークンは約 4 分の 3 語だ。6000 語のレポートを依頼する: 6000 / 0.75 = 8000 トークン。これはちょうど 8,192 未満に収まる。7,000 語を依頼すると、テキストは段落の途中で終わる。
32,768 トークンの天井なら、同じ計算で 1 回の回答が 24576 語になる(32768 × 0.75 = 24576)。そのため、生成コード、長いレポート、章全体の下書きも 1 回の返信に収まる。返信が実際に切れると、API はそれを知らせる。finish_reason は length として返る(なぜそうなるのか、どう直すか)。
クイックチェック
出力上限が 8,192 トークンのモデルに 12,000 語のレポートを依頼する。何が得られるか?
答えを表示
答え: 途中で止まるレポート。finish_reason は length に設定される
12,000 語は約 16,000 トークンで、上限の 2 倍だ。モデルは天井に達するまで書き続けて止まり、API はその返信を finish_ で示す。
速度: 自分で測る唯一の数値#
速度は実際には 2 つの数値だ。最初のテキストが現れるまでの時間と、残りがどれだけ速くストリームで流れてくるか。どちらも負荷、プロンプト長、時間帯によって変わるため、表からコピーした数値は良い指標にならない。自分のプロンプトで測ろう。これには 1 分かかり、少しのトークンを使う(キーは環境変数から取得する。作成方法はドキュメントを参照):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
1 行が得られる: first text after <N>s, finished after <M>s。モデル ID を zai- や MiniMaxAI/ に差し替え、それぞれ数回実行すれば、あなたのプロンプトでの速度比較ができる。それは重要か?ライブチャットなら、はい。人は最初の単語の前の間を気にする。夜間の要約バッチなら誰も見ておらず、速度はリストの最下位に落ちる。
価格: 入力と出力を足し合わせる#
価格は 100 万トークンあたりで示されるが、支払うのはリクエスト単位であり、リクエストには入力側と出力側の両方がある。だからモデルは 2 つの列ではなく、ワークロードで比較しよう。あなたのサポートボットが 1 日 1,000 件のチケットを処理し、各チケットが入力約 300 トークン、出力 150 トークンだとしよう(仮定。自分の数値に置き換えてほしい)。表はライブで、現在の価格から再計算される:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
リクエストあたり 300 入力トークンと 150 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
列ではなく合計を読もう。入力と出力を合計すると、3 つともその表の OpenRouter 列にある OpenRouter の参考価格より安くなる。
そしてここがエージェントの落とし穴だ。コンテキストの節で見た 20 ステップの実行は、420,000 トークンを入力し、おそらく 4,000 トークンを出力する(1 ステップあたり 200、これも仮定)。DeepSeek-V4-Flash では、そのような実行 1 回のコストは $0.0067 だ。1 日に 5 回なら?スライダーを動かして 3 つのモデルを見てみよう:
コスト計算機
エージェント作業の 1 日: 20 ステップのタスク 5 回
リクエストあたりの入力トークン数: 21,000 · リクエストあたりの出力トークン数: 200 · 1日あたりのリクエスト数: 100
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
モデル価格は 1 日のどの時間でも同じなので、今計算した結果は夜間バッチにも当てはまる。出力トークンが通常入力より高くつく理由をもう一度確認したい場合は、入力トークンと出力トークンを参照。
タスク別にモデルを選ぶ#
タスクから始め、最も厳しく効いてくる数値を見つけ、その後で残りの 3 つを確認する。自分のケースをクリックして進もう:
ケースを選ぶ
自分のタスクにはどのモデル?
オプションを選択して答えを表示
短い回答のサポートボット
質問と回答は短いので、カタログのどのモデルにも余裕があり、価格の列が決め手になる。典型的なチケットを上のコスト表で実行し、あなたの数値で合計が良く見える方、GLM-5.3-Flash か MiniMax-M2.7 から始めよう。
多くのファイルを読むコーディングアシスタント
コンテキストが最優先だ。GLM-5.3-Flash は 3 つの中で最大の 390K のウィンドウを持ち、DeepSeek-V4-Flash は 380K だ。MiniMax-M2.7 の 180K は、一緒に送るファイルがそれを十分下回るなら十分だ。
多くのステップをループするエージェント
履歴は各ステップで再送信されるため、合計は急速に増える。DeepSeek-V4-Flash は 380K のコンテキストと 1 回答あたり最大 32,768 の出力トークン、そしてどの時間でも同じ価格を組み合わせており、長いループを予測可能にする。合計は上の計算機で確認しよう。
長いレポートと生成コード
最大出力が決め手だ。DeepSeek-V4-Flash は 1 回答あたり最大 32,768 トークンを書く。GLM-5.3-Flash と MiniMax-M2.7 は最大 8,192 で、約 6,000 語のレポートをカバーする。
すべての行で勝つ単一のモデルはない。だからこそ、決める前に同じ 10 個の実際のプロンプトを 2 つの候補で実行してみる価値がある。GLM vs DeepSeek vs MiniMax の比較では 3 つのモデルをより深く掘り下げており、料金ページには常に現在の数値が表示されている。


