Paano pumili ng AI model: context, output, bilis, presyo
Pumili ng modelo para sa chat, coding o agent gamit ang apat na numero: context window, max output, bilis at presyo. Mga halimbawang may kalkulasyon at live na cost table.
Sa pahinang ito
Isang listahan ng modelo na may apatnapung pangalan, isang gawain na inilarawan sa isang pangungusap, at walang malinaw na ugnayan sa pagitan ng dalawa. Narito ang maikling sagot: suriin ang apat na numero, sa ganitong pagkakasunod-sunod. Context window at maximum output ang nagpapasya kung kaya ng isang modelo ang iyong gawain. Bilis at presyo ang nagpapasya kung gaano ito kaaya-aya at kamahal. Ang context, output limit at presyo ay nakalista sa models page at sa pricing table; ang bilis ay ikaw mismo ang sumusukat sa loob ng mga isang minuto, at ang script ay nasa ibaba.
Ang apat na numero sa simpleng salita#
Isipin ang modelo bilang isang kasamahan sa isang mesa. Ang context window ay ang laki ng mesa: lahat ng kailangang nasa harap nila nang sabay. Ang maximum output ay kung gaano katagal sila makakapagsalita sa isang pagkakataon. Ang bilis ay kung gaano kabilis sila magsimulang sumagot. Ang presyo ay ang kanilang orasang bayad. Apat na termino, at makikita mo ang lahat ng ito sa bawat API doc:
Mga flashcard
Mga salitang makikita mo sa bawat listahan ng modelo
I-tap ang card para i-flip ito
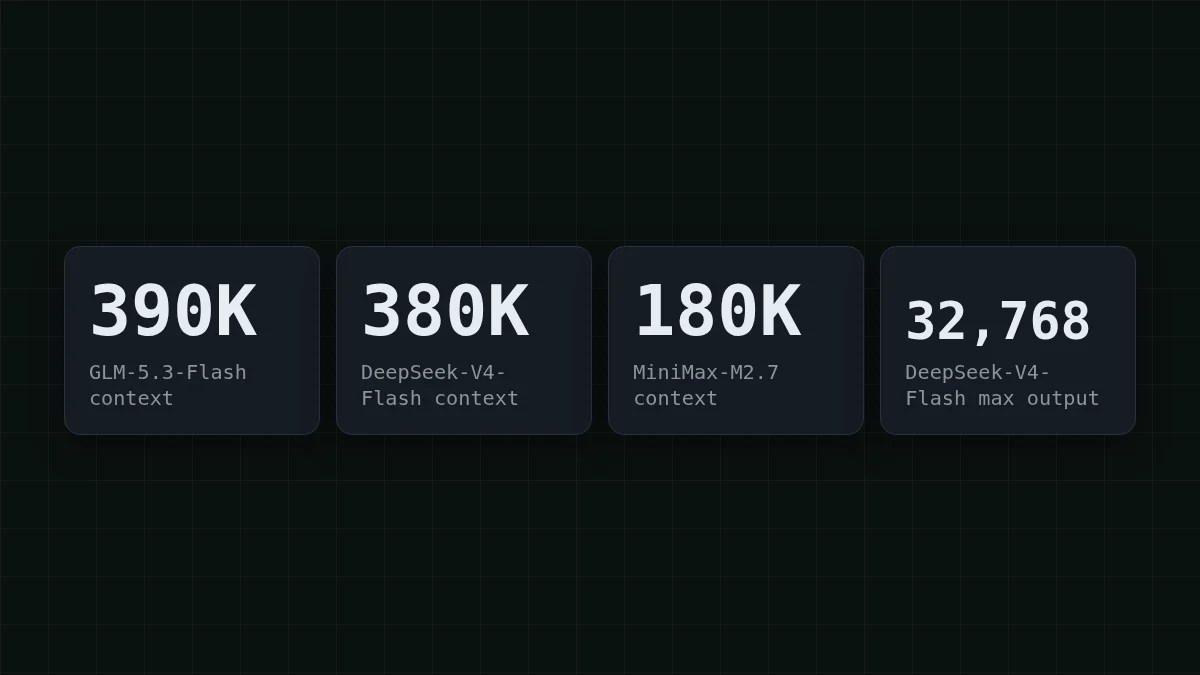
Upang gawing konkretong halimbawa, narito ang unang dalawang numero para sa tatlong modelo sa catalog ng CheapTokens, mula sa CheapTokens model reference (27 Oktubre 2026): Ang GLM-5.3-Flash ay may 390K context at sumasagot ng hanggang 8,192 tokens; Ang DeepSeek-V4-Flash (release 0731) ay may 380K at sumasagot ng hanggang 32,768 tokens; Ang MiniMax-M2.7 ay may 180K at sumasagot ng hanggang 8,192 tokens.
Context: kasya ba ang lahat ng ipapadala mo?#
Sabihin nating ang iyong coding assistant ay nagbubukas ng 12 file na may mga 3,000 tokens bawat isa, pagkatapos ay idinadagdag ang iyong tanong at ang sarili nitong mga tala. 12 × 3,000 = 36,000 tokens. Kahit ang pinakamaliit na window sa itaas, 180K, ay may sapat na espasyo para dito. Ang isang napakalaking file o isang buong repository dump ang punto kung saan nagsisimulang maging mahalaga ang window.
Ang mga chat at agent ay mas mahirap, dahil ang API ay muling nagpapadala ng buong history sa bawat tawag. Kunin ang isang agent na tumatakbo ng 20 hakbang, at ang bawat hakbang ay nagdadagdag ng mga 2,000 tokens ng tool output at tugon (isang palagay para sa halimbawang ito). Ang hakbang 1 ay nagpapadala ng 2,000 tokens, ang hakbang 2 ay nagpapadala ng 4,000, ang hakbang 20 ay nagpapadala ng 40,000. Sa buong takbo, nagpapadala ito ng 2,000 × 210 = 420,000 tokens, kung saan ang 210 ay 1 + 2 + … + 20.
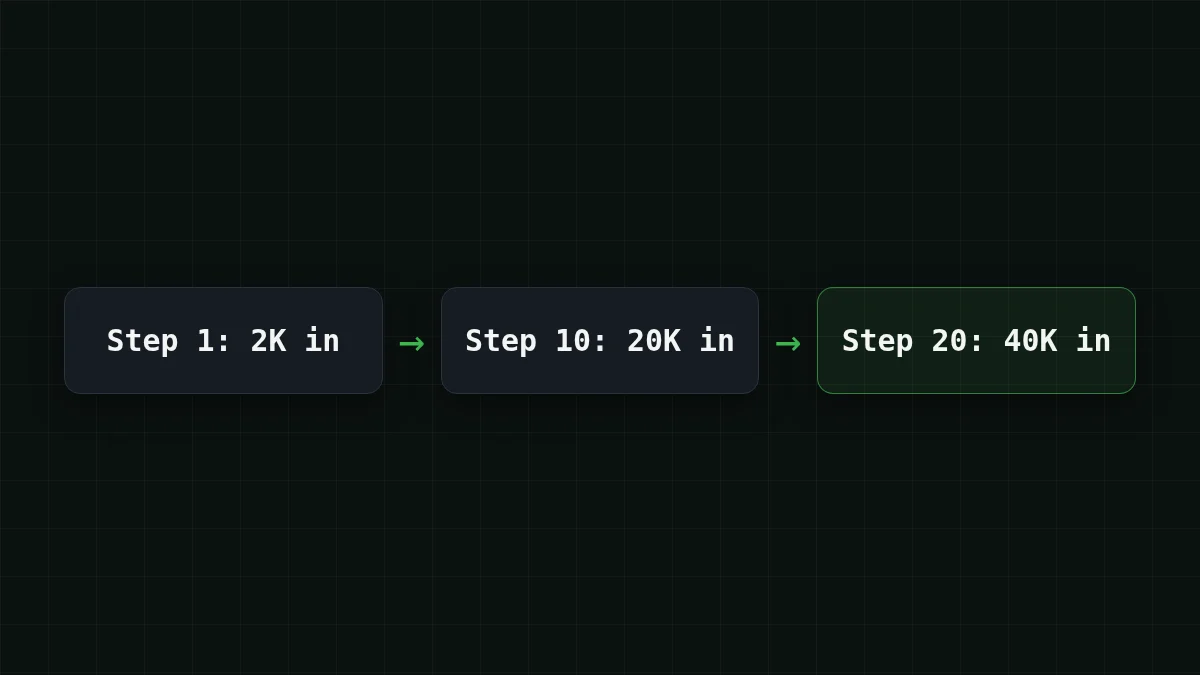
Dalawang magkaibang tanong ang nakatago dito. Ang context window ay nag-aalala lamang sa pinakamalaking solong request: 40,000 tokens sa hakbang 20, na kayang hawakan ng bawat modelo sa catalog nang madali. Ang bill ay nag-aalala sa kabuuan, 420,000 tokens. Itago ang dalawa sa iyong isipan, at hindi ka pipili ng modelo sa maling dahilan.
Haba ng output: ang limitasyong pumuputol sa mga sagot#
Ang output limit ay isang kisame sa isang tugon, at madaling makalimutan hanggang sa ang isang sagot ay huminto sa gitna ng pangungusap. Isang tuntunin para sa Ingles: ang isang token ay mga tatlong-kapat ng isang salita. Humihingi ka ng ulat na 6000 salita: 6000 / 0.75 = 8000 tokens. Kasya lang ito sa ilalim ng 8,192. Humingi ka ng 7,000 salita at ang teksto ay nagtatapos sa gitna ng isang talata.
Sa isang 32,768-token na kisame, ang parehong aritmetika ay nagbibigay ng 24576 salita sa isang sagot (32768 × 0.75 = 24576), kaya ang nabuong code, mahahabang ulat at mga draft ng buong kabanata ay kasya sa isang tugon. Kapag ang isang tugon ay naputol, sinasabi ito ng API: finish_reason ay bumabalik bilang length (bakit nangyayari iyon at paano ayusin).
Mabilisang pagsusuri
Humihingi ka sa isang modelo na may 8,192-token output limit ng isang 12,000-salitang ulat. Ano ang makukuha mo?
Ipakita ang sagot
Sagot: Isang ulat na huminto sa kalagitnaan, na may finish_reason na nakatakda sa length
Ang 12,000 salita ay mga 16,000 tokens, dalawang beses ang cap. Ang modelo ay nagsusulat hanggang maabot ang kisame at huminto, at minamarkahan ng API ang tugon ng finish_.
Bilis: ang nag-iisang numerong ikaw mismo ang sumusukat#
Ang bilis ay talagang dalawang numero: kung gaano katagal bago lumitaw ang unang teksto, at kung gaano kabilis dumaloy ang natitira. Pareho silang nagbabago ayon sa load, haba ng prompt at oras ng araw, kaya ang figure na kinopya mula sa talahanayan ay mahinang gabay. Sukatin ito sa iyong sariling prompt. Tumatagal ito ng isang minuto at gumagamit ng ilang tokens (ang key ay nagmumula sa isang environment variable; tingnan ang docs para sa paggawa ng isa):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Makakakuha ka ng isang linya: first text after <N>s, finished after <M>s. Palitan ang model id ng zai- o MiniMaxAI/, patakbuhin ang bawat isa ng ilang beses, at mayroon ka nang paghahambing ng bilis para sa iyong prompt. Mahalaga ba ito? Para sa live na chat, oo: napapansin ng mga tao ang paghinto bago ang unang salita. Para sa gabi-gabing batch ng mga buod, walang nanonood, at ang bilis ay bumaba sa ilalim ng iyong listahan.
Presyo: pagsamahin ang input at output#
Ang mga presyo ay sinipi bawat milyong tokens, ngunit nagbabayad ka bawat request, at ang isang request ay may parehong input side at output side. Kaya ihambing ang mga modelo sa isang workload, hindi sa dalawang column. Sabihin nating ang iyong support bot ay humahawak ng 1,000 ticket bawat araw, bawat isa ay mga 300 tokens in at 150 out (isang palagay; palitan ito ng sarili mong numero). Ang talahanayan ay live at muling kinakalkula mula sa kasalukuyang mga presyo:
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 input at 150 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Basahin ang kabuuan, hindi ang mga column. Sa kabuuan, kasama ang input at output, ang bawat isa sa tatlo ay lumalabas na mas mura kaysa sa reference price ng OpenRouter sa column ng OpenRouter ng talahanayang iyon.
At dito kumakagat ang mga agent. Ang 20-hakbang na takbo mula sa seksyon ng context ay nagpapadala ng 420,000 tokens in at nagsusulat ng mga 4,000 out (200 bawat hakbang, isang palagay muli). Sa DeepSeek-V4-Flash, ang isang ganoong takbo ay nagkakahalaga ng $0.0067. Limang takbo sa isang araw? Ilipat ang mga slider at panoorin ang tatlong modelo:
Calculator ng gastos
Isang araw ng agent work: limang 20-hakbang na gawain
Mga input token bawat kahilingan: 21,000 · Mga output token bawat kahilingan: 200 · Mga kahilingan bawat araw: 100
| Modelo | Bawat araw | Bawat buwan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Ang mga presyo ng modelo ay nananatiling pareho sa anumang oras ng araw, kaya ang kalkulasyon na ginawa mo ngayon ay may bisa rin para sa gabi-gabing batch. Para sa refresher kung bakit ang output tokens ay karaniwang mas mahal kaysa sa input, tingnan ang input and output tokens.
Pumili ng modelo ayon sa gawain#
Magsimula sa gawain, hanapin ang numerong pinakamalakas kumagat, at suriin ang iba pang tatlo pagkatapos. I-click ang sarili mong kaso:
Piliin ang iyong kaso
Aling modelo para sa aking gawain?
Pumili ng opsyon upang makita ang sagot
Isang support bot na may maiikling sagot
Ang mga tanong at sagot ay maikli, kaya ang bawat modelo sa catalog ay may labis na espasyo, at ang column ng presyo ang nagpapasya. Patakbuhin ang iyong karaniwang ticket sa cost table sa itaas at magsimula sa GLM-5.3-Flash o MiniMax-M2.7, alinman sa kabuuang mas maganda para sa iyong mga numero.
Isang coding assistant na nagbabasa ng maraming file
Context muna. Ang GLM-5.3-Flash ay may pinakamalaking window sa tatlo sa 390K, ang DeepSeek-V4-Flash ay may 380K. Ang MiniMax-M2.7 sa 180K ay sapat kapag ang mga file na ipinapadala mo nang sabay ay nananatiling mas mababa sa ganoon.
Isang agent na umiikot sa maraming hakbang
Ang history ay muling ipinapadala sa bawat hakbang, kaya mabilis na lumalaki ang kabuuan. Pinagsasama ng DeepSeek-V4-Flash ang 380K context at hanggang 32,768 output tokens bawat sagot at isang presyo sa anumang oras, na nagpapanatili ng predictability sa mahabang loop. Suriin ang kabuuan gamit ang calculator sa itaas.
Mahahabang ulat at nabuong code
Max output ang nagpapasya. Ang DeepSeek-V4-Flash ay nagsusulat ng hanggang 32,768 tokens bawat sagot; Ang GLM-5.3-Flash at MiniMax-M2.7 ay nagsusulat ng hanggang 8,192, na sumasaklaw sa isang ulat na mga 6,000 salita.
Walang nag-iisang modelo ang nananalo sa bawat row, kaya nakakatulong na patakbuhin ang parehong sampung tunay na prompt sa dalawang kandidato bago ka magpasya. Ang GLM vs DeepSeek vs MiniMax comparison ay mas malalim sa tatlong modelo, at ang pricing page ay palaging nagpapakita ng kasalukuyang mga numero.


