IA pour débutantsGuide
Comment choisir un modèle d'IA : contexte, sortie, vitesse, prix
Choisissez un modèle pour le chat, le codage ou un agent avec quatre nombres : fenêtre de contexte, sortie maximale, vitesse et prix. Exemples concrets et tableau de coûts dynamique.
Sur cette page
Une liste de modèles avec quarante noms, une tâche décrite en une phrase, et aucun lien évident entre les deux. Voici la réponse courte : vérifiez quatre nombres, dans cet ordre. La fenêtre de contexte et la sortie maximale décident si un modèle peut accomplir votre tâche. La vitesse et le prix décident de son confort et de son coût. Le contexte, la limite de sortie et le prix sont indiqués sur la page des modèles et dans le tableau des tarifs ; la vitesse, vous la mesurez vous-même en une minute environ, et le script est ci-dessous.
Les quatre nombres en clair#
Imaginez le modèle comme un collègue à un bureau. La fenêtre de contexte est la taille du bureau : tout ce qui doit être devant lui en même temps. La sortie maximale est la durée pendant laquelle il peut parler d'un seul coup. La vitesse est le temps qu'il met à commencer à répondre. Le prix est son tarif horaire. Quatre termes, et vous les rencontrerez dans chaque documentation d'API :
Cartes mémo
Les termes que vous rencontrerez dans chaque liste de modèles
Touchez une carte pour la retourner
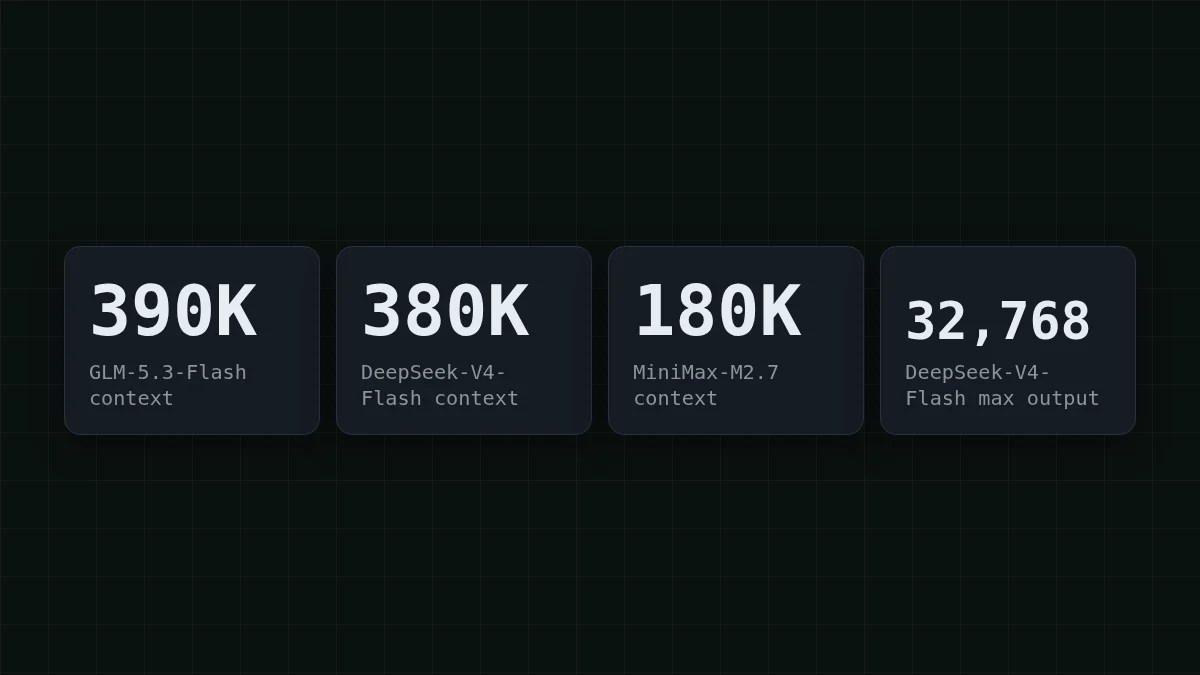
Pour rendre cela concret, voici les deux premiers nombres pour les trois modèles du catalogue CheapTokens, d'après la référence des modèles CheapTokens (27 octobre 2026) : GLM-5.3-Flash a un contexte de 390K et répond jusqu'à 8 192 tokens ; DeepSeek-V4-Flash (version 0731) a 380K et répond jusqu'à 32 768 tokens ; MiniMax-M2.7 a 180K et répond jusqu'à 8 192 tokens.
Contexte : tout ce que vous envoyez tiendra-t-il ?#
Supposons que votre assistant de codage ouvre 12 fichiers d'environ 3 000 tokens chacun, puis ajoute votre question et ses propres notes. 12 × 3 000 = 36 000 tokens. Même la plus petite fenêtre ci-dessus, 180K, contient cela avec beaucoup de marge. C'est avec un seul fichier énorme ou un dépôt entier que la fenêtre commence à compter.
Les chats et les agents sont plus délicats, car l'API renvoie tout l'historique à chaque appel. Prenons un agent qui exécute 20 étapes, et chaque étape ajoute environ 2 000 tokens de sortie d'outil et de réponse (une hypothèse pour cet exemple). L'étape 1 envoie 2 000 tokens, l'étape 2 en envoie 4 000, l'étape 20 en envoie 40 000. Sur l'ensemble de l'exécution, il envoie 2 000 × 210 = 420 000 tokens, où 210 = 1 + 2 + … + 20.
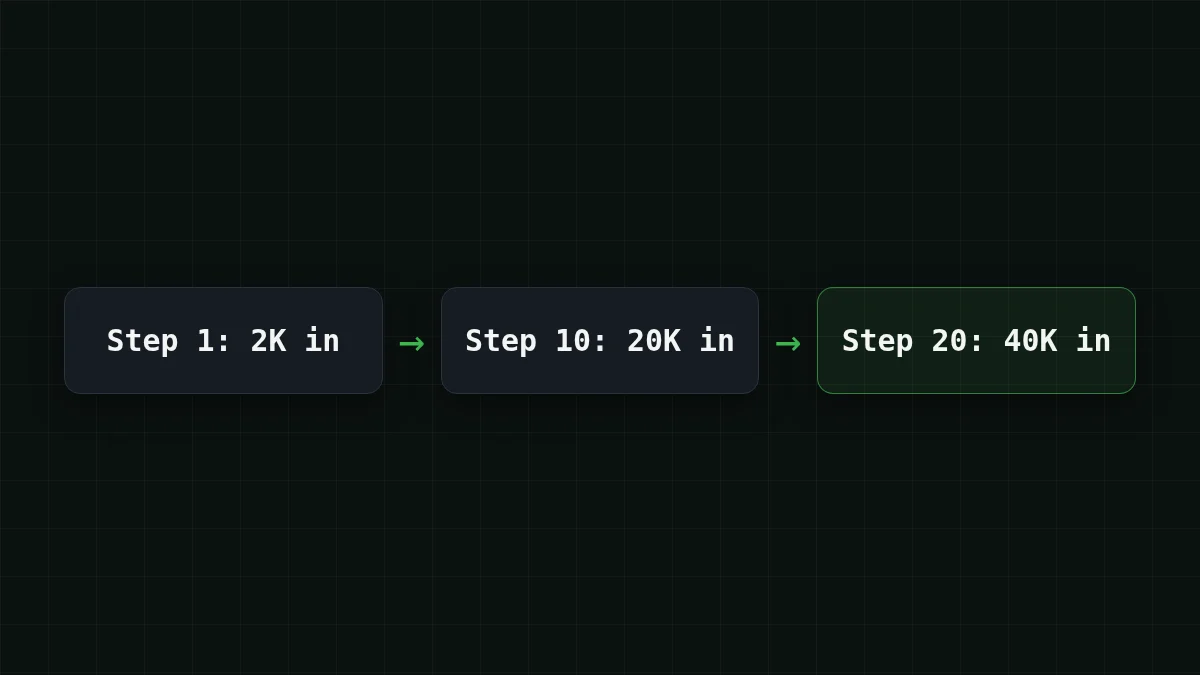
Deux questions différentes se cachent ici. La fenêtre de contexte ne se soucie que de la plus grande requête unique : 40 000 tokens à l'étape 20, ce que tous les modèles du catalogue contiennent facilement. La facture se soucie du total, 420 000 tokens. Gardez les deux en tête, et vous ne choisirez pas un modèle pour la mauvaise raison.
Longueur de sortie : la limite qui coupe les réponses#
La limite de sortie est un plafond pour une réponse, et il est facile de l'oublier jusqu'à ce qu'une réponse s'arrête au milieu d'une phrase. Une règle empirique pour l'anglais : un token représente environ trois quarts d'un mot. Vous demandez un rapport de 6 000 mots : 6 000 / 0,75 = 8 000 tokens. Cela passe tout juste sous 8 192. Demandez 7 000 mots et le texte s'arrête au milieu d'un paragraphe.
Avec un plafond de 32 768 tokens, le même calcul donne 24 576 mots en une réponse (32 768 × 0,75 = 24 576), donc le code généré, les longs rapports et les brouillons de chapitres entiers tiennent en une seule réponse. Quand une réponse est coupée, l'API vous le dit : finish_reason revient comme length (pourquoi cela arrive et comment y remédier).
Vérification rapide
Vous demandez à un modèle avec une limite de sortie de 8 192 tokens un rapport de 12 000 mots. Qu'obtenez-vous ?
Afficher la réponse
Réponse: Un rapport qui s'arrête à mi-chemin, avec finish_reason défini sur length
12 000 mots représentent environ 16 000 tokens, soit le double du plafond. Le modèle écrit jusqu'à atteindre le plafond et s'arrête, et l'API marque la réponse avec finish_.
Vitesse : le seul nombre que vous mesurez vous-même#
La vitesse, ce sont en réalité deux nombres : le temps avant l'apparition du premier texte, et la vitesse à laquelle le reste arrive. Les deux varient avec la charge, la longueur du prompt et l'heure de la journée, donc un chiffre copié dans un tableau est un mauvais guide. Mesurez-la sur votre propre prompt. Cela prend une minute et consomme quelques tokens (la clé provient d'une variable d'environnement ; voir la documentation pour en créer une) :
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Vous obtenez une ligne : first text after <N>s, finished after <M>s. Remplacez l'identifiant du modèle par zai- ou MiniMaxAI/, exécutez chacun plusieurs fois, et vous avez une comparaison de vitesse pour votre prompt. Est-ce important ? Pour un chat en direct, oui : les gens remarquent une pause avant le premier mot. Pour un lot nocturne de résumés, personne ne regarde, et la vitesse descend en bas de votre liste.
Prix : additionnez l'entrée et la sortie#
Les prix sont indiqués par million de tokens, mais vous payez par requête, et une requête a à la fois un côté entrée et un côté sortie. Comparez donc les modèles sur une charge de travail, pas sur deux colonnes. Supposons que votre bot de support traite 1 000 tickets par jour, chacun d'environ 300 tokens en entrée et 150 en sortie (une hypothèse ; remplacez-la par la vôtre). Le tableau est dynamique et se recalcule à partir des prix actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 tokens d'entrée et 150 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Lisez le total, pas les colonnes. Au total, en comptant l'entrée et la sortie ensemble, chacun des trois revient moins cher que le prix de référence d'OpenRouter dans la colonne OpenRouter de ce tableau.
Et c'est là que les agents font mal. L'exécution en 20 étapes de la section sur le contexte envoie 420 000 tokens en entrée et écrit peut-être 4 000 en sortie (200 par étape, encore une hypothèse). Sur DeepSeek-V4-Flash, une telle exécution coûte $0.0067. Cinq exécutions par jour ? Déplacez les curseurs et observez les trois modèles :
Calculateur de coût
Une journée de travail d'agent : cinq tâches de 20 étapes
Tokens d'entrée par requête: 21 000 · Tokens de sortie par requête: 200 · Requêtes par jour: 100
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Les prix des modèles restent les mêmes à toute heure de la journée, donc un calcul fait maintenant vaut aussi pour le lot du soir. Pour un rappel sur la raison pour laquelle les tokens de sortie coûtent généralement plus cher que ceux d'entrée, voir tokens d'entrée et de sortie.
Choisir un modèle selon la tâche#
Partez de la tâche, trouvez le nombre qui compte le plus, puis vérifiez les trois autres. Cliquez sur votre propre cas :
Choisissez votre cas
Quel modèle pour ma tâche ?
Choisissez une option pour voir la réponse
Un bot de support avec des réponses courtes
Les questions et les réponses sont courtes, donc tous les modèles du catalogue ont de la marge, et la colonne du prix décide. Faites passer votre ticket typique dans le tableau des coûts ci-dessus et commencez par GLM-5.3-Flash ou MiniMax-M2.7, selon le total qui semble le meilleur pour vos chiffres.
Un assistant de codage qui lit de nombreux fichiers
Le contexte passe en premier. GLM-5.3-Flash a la plus grande fenêtre des trois avec 390K, DeepSeek-V4-Flash a 380K. MiniMax-M2.7 à 180K suffit quand les fichiers que vous envoyez ensemble restent bien en dessous.
Un agent qui boucle sur de nombreuses étapes
L'historique est renvoyé à chaque étape, donc le total croît vite. DeepSeek-V4-Flash combine un contexte de 380K avec jusqu'à 32 768 tokens de sortie par réponse et un prix unique à toute heure, ce qui rend les longues boucles prévisibles. Vérifiez le total avec le calculateur ci-dessus.
Rapports longs et code généré
La sortie maximale décide. DeepSeek-V4-Flash écrit jusqu'à 32 768 tokens par réponse ; GLM-5.3-Flash et MiniMax-M2.7 écrivent jusqu'à 8 192, ce qui couvre un rapport d'environ 6 000 mots.
Aucun modèle ne gagne sur toutes les lignes, c'est pourquoi il est utile de faire passer les mêmes dix prompts réels par deux candidats avant de vous engager. La comparaison GLM vs DeepSeek vs MiniMax approfondit les trois modèles, et la page des tarifs affiche toujours les chiffres actuels.


