AI मॉडल कैसे चुनें: कॉन्टेक्स्ट, आउटपुट, गति, मूल्य
चार संख्याओं के साथ चैट, कोडिंग या एजेंट के लिए मॉडल चुनें: कॉन्टेक्स्ट विंडो, अधिकतम आउटपुट, गति और मूल्य। हल किए गए उदाहरण और एक लाइव लागत तालिका।
इस पृष्ठ पर
चालीस नामों वाली मॉडल सूची, एक वाक्य में वर्णित कार्य, और दोनों के बीच कोई स्पष्ट संबंध नहीं। यहाँ संक्षिप्त उत्तर है: चार संख्याएँ जाँचें, इसी क्रम में। कॉन्टेक्स्ट विंडो और अधिकतम आउटपुट तय करते हैं कि कोई मॉडल आपका कार्य कर ही सकता है या नहीं। गति और मूल्य तय करते हैं कि यह कितना सुखद और कितना महंगा है। कॉन्टेक्स्ट, आउटपुट सीमा और मूल्य मॉडल पृष्ठ और मूल्य तालिका में सूचीबद्ध हैं; गति आप स्वयं लगभग एक मिनट में जाँचते हैं, और स्क्रिप्ट नीचे है।
चार संख्याएँ सरल शब्दों में#
मॉडल को डेस्क पर बैठे सहयोगी की तरह सोचें। कॉन्टेक्स्ट विंडो डेस्क का आकार है: वह सब कुछ जो एक साथ उनके सामने होना चाहिए। अधिकतम आउटपुट यह है कि वे एक बार में कितनी देर बोल सकते हैं। गति यह है कि वे कितनी जल्दी उत्तर देना शुरू करते हैं। मूल्य उनकी प्रति घंटा दर है। चार शब्द, और आप इन सभी से हर API दस्तावेज़ में मिलेंगे:
फ्लैशकार्ड
हर मॉडल सूची में मिलने वाले शब्द
पलटने के लिए कार्ड पर टैप करें
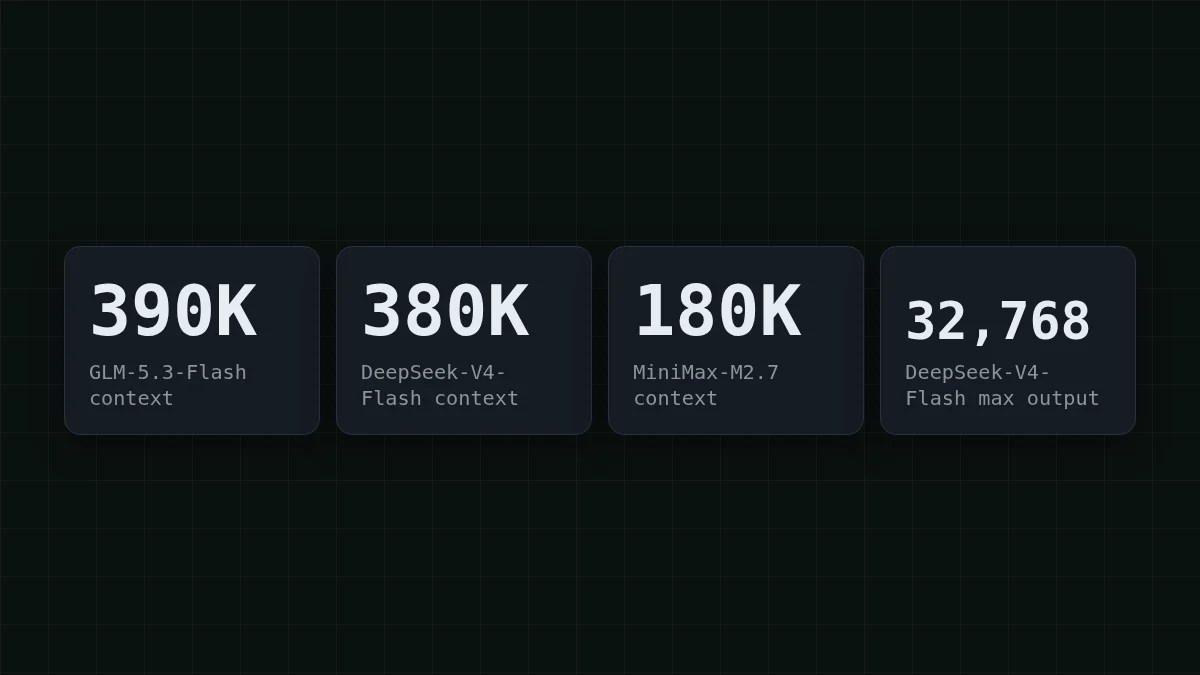
इसे ठोस बनाने के लिए, CheapTokens कैटलॉग के तीन मॉडलों के लिए पहली दो संख्याएँ यहाँ हैं, CheapTokens मॉडल संदर्भ (27 अक्टूबर 2026) से: GLM-5.3-Flash में 390K कॉन्टेक्स्ट है और यह अधिकतम 8,192 टोकन तक उत्तर देता है; DeepSeek-V4-Flash (रिलीज़ 0731) में 380K है और यह अधिकतम 32,768 टोकन तक उत्तर देता है; MiniMax-M2.7 में 180K है और यह अधिकतम 8,192 टोकन तक उत्तर देता है।
कॉन्टेक्स्ट: क्या आपका भेजा सब कुछ फिट होगा?#
मान लें कि आपका कोडिंग सहायक लगभग 3,000 टोकन की 12 फ़ाइलें खोलता है, फिर आपका प्रश्न और अपने नोट्स जोड़ता है। 12 × 3,000 = 36,000 टोकन। ऊपर की सबसे छोटी विंडो, 180K, भी इसे बहुत जगह के साथ रखती है। एक बहुत बड़ी फ़ाइल या पूरे रिपॉज़िटरी का डंप वह जगह है जहाँ विंडो मायने रखने लगती है।
चैट और एजेंट अधिक पेचीदा हैं, क्योंकि API हर कॉल के साथ पूरा इतिहास दोबारा भेजता है। मान लें एक एजेंट 20 चरण चलाता है, और प्रत्येक चरण लगभग 2,000 टोकन टूल आउटपुट और उत्तर जोड़ता है (इस उदाहरण के लिए एक अनुमान)। चरण 1 में 2,000 टोकन भेजे जाते हैं, चरण 2 में 4,000, चरण 20 में 40,000। पूरे रन में यह 2,000 × 210 = 420,000 टोकन भेजता है, जहाँ 210 = 1 + 2 + … + 20 है।
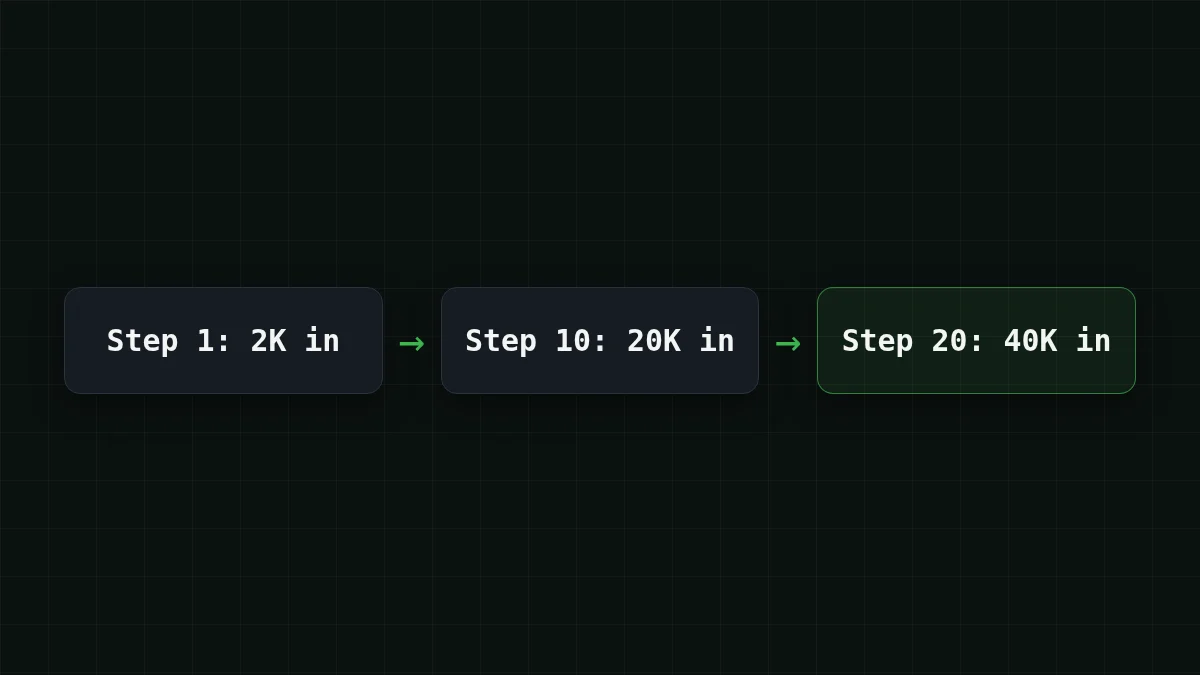
यहाँ दो अलग प्रश्न छिपे हैं। कॉन्टेक्स्ट विंडो केवल सबसे बड़े एकल अनुरोध की परवाह करती है: चरण 20 पर 40,000 टोकन, जिसे कैटलॉग का हर मॉडल आसानी से रखता है। बिल कुल की परवाह करता है, 420,000 टोकन। दोनों को ध्यान में रखें, और आप गलत कारण से मॉडल नहीं चुनेंगे।
आउटपुट लंबाई: वह सीमा जो उत्तरों को काट देती है#
आउटपुट सीमा एक उत्तर पर ऊपरी सीमा है, और इसे तब तक भूलना आसान है जब तक कोई उत्तर बीच वाक्य में रुक न जाए। अंग्रेज़ी के लिए एक अनुमानित नियम: एक टोकन लगभग एक शब्द का तीन-चौथाई होता है। आप 6000 शब्दों की रिपोर्ट माँगते हैं: 6000 / 0.75 = 8000 टोकन। यह 8,192 के ठीक नीचे फिट होता है। 7,000 शब्द माँगें और टेक्स्ट पैराग्राफ के बीच में समाप्त हो जाता है।
32,768-टोकन की सीमा के साथ वही गणना एक उत्तर में 24576 शब्दों तक पहुँचती है (32768 × 0.75 = 24576), इसलिए जनरेट किया गया कोड, लंबी रिपोर्टें और पूरे अध्यायों के ड्राफ्ट एक ही उत्तर में फिट हो जाते हैं। जब कोई उत्तर कट जाता है, तो API आपको बताता है: finish_reason length के रूप में वापस आता है (ऐसा क्यों होता है और इसे कैसे ठीक करें)।
त्वरित जाँच
आप 8,192-टोकन आउटपुट सीमा वाले मॉडल से 12,000 शब्दों की रिपोर्ट माँगते हैं। आपको क्या मिलता है?
उत्तर दिखाएँ
उत्तर: एक रिपोर्ट जो बीच में रुक जाती है, finish_reason length पर सेट होता है
12,000 शब्द लगभग 16,000 टोकन हैं, जो सीमा से दोगुना है। मॉडल तब तक लिखता है जब तक वह सीमा तक नहीं पहुँच जाता और रुक जाता है, और API उत्तर को finish_ से चिह्नित करता है।
गति: वह एक संख्या जिसे आप स्वयं मापते हैं#
गति वास्तव में दो संख्याएँ हैं: पहला टेक्स्ट आने में कितना समय लगता है, और बाकी कितनी तेज़ी से स्ट्रीम होता है। दोनों लोड, प्रॉम्प्ट लंबाई और दिन के समय के साथ बदलते हैं, इसलिए तालिका से कॉपी किया गया आँकड़ा खराब मार्गदर्शक है। इसे अपने प्रॉम्प्ट पर मापें। इसमें एक मिनट लगता है और कुछ टोकन खर्च होते हैं (कुंजी एक पर्यावरण चर से आती है; बनाने के लिए दस्तावेज़ देखें):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
आपको एक पंक्ति मिलती है: first text after <N>s, finished after <M>s। मॉडल आईडी को zai- या MiniMaxAI/ से बदलें, प्रत्येक को कुछ बार चलाएँ, और आपके पास अपने प्रॉम्प्ट के लिए गति तुलना होगी। क्या यह मायने रखता है? लाइव चैट के लिए, हाँ: लोग पहले शब्द से पहले के ठहराव को नोटिस करते हैं। रात्रिकालीन सारांश बैच के लिए, कोई देख नहीं रहा होता, और गति आपकी सूची में सबसे नीचे आ जाती है।
मूल्य: इनपुट और आउटपुट को जोड़ें#
कीमतें प्रति मिलियन टोकन बताई जाती हैं, लेकिन आप प्रति अनुरोध भुगतान करते हैं, और एक अनुरोध में इनपुट पक्ष और आउटपुट पक्ष दोनों होते हैं। इसलिए मॉडलों की तुलना किसी कार्यभार पर करें, दो कॉलमों पर नहीं। मान लें कि आपका सपोर्ट बॉट प्रतिदिन 1,000 टिकट संभालता है, प्रत्येक में लगभग 300 टोकन इनपुट और 150 आउटपुट (एक अनुमान; इसे अपने आँकड़ों से बदलें)। तालिका लाइव है और वर्तमान कीमतों से पुनर्गणना करती है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
प्रति अनुरोध 300 इनपुट और 150 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
कुल पढ़ें, कॉलम नहीं। कुल मिलाकर, इनपुट और आउटपुट को एक साथ गिनते हुए, तीनों में से प्रत्येक उस तालिका के OpenRouter कॉलम में OpenRouter के संदर्भ मूल्य से सस्ता पड़ता है।
और यहीं एजेंट काटते हैं। कॉन्टेक्स्ट अनुभाग से 20-चरणीय रन 420,000 टोकन इनपुट भेजता है और शायद 4,000 आउटपुट लिखता है (प्रति चरण 200, फिर एक अनुमान)। DeepSeek-V4-Flash पर ऐसे एक रन की लागत $0.0067 है। एक दिन में पाँच रन? स्लाइडर घुमाएँ और तीन मॉडलों को देखें:
लागत कैलकुलेटर
एजेंट कार्य का एक दिन: पाँच 20-चरणीय कार्य
प्रति अनुरोध इनपुट टोकन: 21,000 · प्रति अनुरोध आउटपुट टोकन: 200 · प्रति दिन अनुरोध: 100
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
मॉडल की कीमतें दिन के किसी भी घंटे समान रहती हैं, इसलिए अभी की गई गणना शाम के बैच के लिए भी मान्य रहती है। आउटपुट टोकन आमतौर पर इनपुट से अधिक महंगे क्यों होते हैं, इसका पुनश्चर्या के लिए इनपुट और आउटपुट टोकन देखें।
कार्य के अनुसार मॉडल चुनें#
कार्य से शुरू करें, वह संख्या खोजें जो सबसे कठिनता से काटती है, और बाद में अन्य तीन की जाँच करें। अपने स्वयं के मामले पर क्लिक करें:
अपना मामला चुनें
मेरे कार्य के लिए कौन सा मॉडल?
उत्तर देखने के लिए एक विकल्प चुनें
छोटे उत्तरों वाला सपोर्ट बॉट
प्रश्न और उत्तर छोटे हैं, इसलिए कैटलॉग के हर मॉडल में पर्याप्त जगह है, और मूल्य कॉलम निर्णय करता है। अपने सामान्य टिकट को ऊपर की लागत तालिका से चलाएँ और GLM-5.3-Flash या MiniMax-M2.7 से शुरू करें, जो भी आपके आँकड़ों के लिए बेहतर कुल दिखाए।
कई फ़ाइलें पढ़ने वाला कोडिंग सहायक
कॉन्टेक्स्ट पहले आता है। GLM-5.3-Flash में तीनों में सबसे बड़ी विंडो 390K है, DeepSeek-V4-Flash में 380K है। MiniMax-M2.7 का 180K तब पर्याप्त है जब आपके एक साथ भेजी जाने वाली फ़ाइलें उससे काफी कम रहें।
कई चरणों में लूप करने वाला एजेंट
इतिहास हर चरण में दोबारा भेजा जाता है, इसलिए कुल तेज़ी से बढ़ता है। DeepSeek-V4-Flash 380K कॉन्टेक्स्ट को प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन और किसी भी घंटे एक ही कीमत के साथ जोड़ता है, जो लंबे लूप को अनुमानित रखता है। ऊपर कैलकुलेटर से कुल जाँचें।
लंबी रिपोर्टें और जनरेट किया गया कोड
अधिकतम आउटपुट निर्णय करता है। DeepSeek-V4-Flash प्रति उत्तर अधिकतम 32,768 टोकन लिखता है; GLM-5.3-Flash और MiniMax-M2.7 अधिकतम 8,192 लिखते हैं, जो लगभग 6,000 शब्दों की रिपोर्ट को कवर करता है।
कोई एक मॉडल हर पंक्ति नहीं जीतता, इसलिए प्रतिबद्ध होने से पहले दो उम्मीदवारों के माध्यम से वही दस वास्तविक प्रॉम्प्ट चलाना मदद करता है। GLM बनाम DeepSeek बनाम MiniMax तुलना तीन मॉडलों पर गहराई से जाती है, और मूल्य पृष्ठ हमेशा वर्तमान संख्याएँ दिखाता है।


