Cómo elegir un modelo de IA: contexto, salida, velocidad, precio
Elige un modelo para chat, programación o un agente con cuatro números: ventana de contexto, salida máxima, velocidad y precio. Ejemplos resueltos y una tabla de costos dinámica.
En esta página
Una lista de modelos con cuarenta nombres, una tarea descrita en una frase y ningún vínculo obvio entre ambos. Aquí está la respuesta breve: revisa cuatro números, en este orden. La ventana de contexto y la salida máxima deciden si un modelo puede hacer tu tarea siquiera. La velocidad y el precio deciden cuán agradable y cuán caro es. El contexto, el límite de salida y el precio aparecen en la página de modelos y en la tabla de precios; la velocidad la mides tú mismo en aproximadamente un minuto, y el script está abajo.
Los cuatro números en palabras sencillas#
Piensa en el modelo como un colega en un escritorio. La ventana de contexto es el tamaño del escritorio: todo lo que tiene que estar frente a él a la vez. La salida máxima es cuánto puede hablar de una sola vez. La velocidad es cuán rápido empieza a responder. El precio es su tarifa por hora. Cuatro términos, y te los encontrarás en toda documentación de API:
Tarjetas de memoria
Palabras que verás en toda lista de modelos
Toca una tarjeta para voltearla
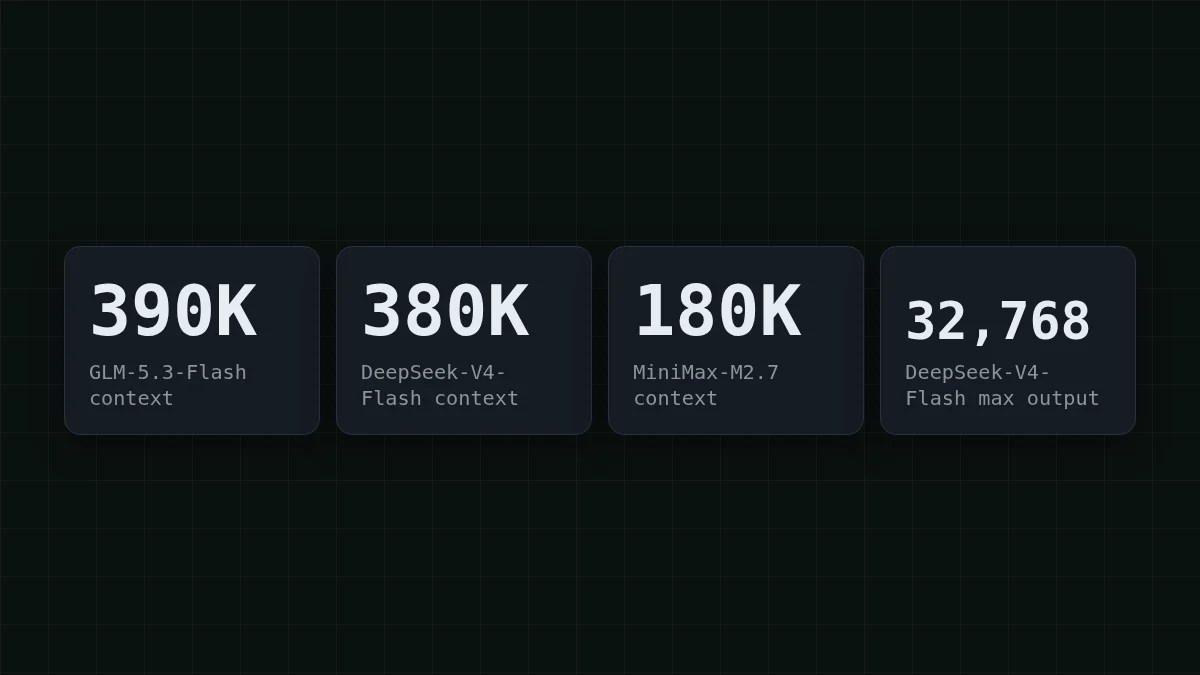
Para hacerlo concreto, aquí están los dos primeros números de los tres modelos del catálogo de CheapTokens, según la referencia de modelos de CheapTokens (27 de octubre de 2026): GLM-5.3-Flash tiene un contexto de 390K y responde hasta 8.192 tokens; DeepSeek-V4-Flash (versión 0731) tiene 380K y responde hasta 32.768 tokens; MiniMax-M2.7 tiene 180K y responde hasta 8.192 tokens.
Contexto: ¿cabe todo lo que envías?#
Digamos que tu asistente de programación abre 12 archivos de unos 3.000 tokens cada uno, luego añade tu pregunta y sus propias notas. 12 × 3.000 = 36.000 tokens. Incluso la ventana más pequeña de arriba, 180K, lo contiene con amplio margen. Un solo archivo enorme o un volcado de todo un repositorio es donde la ventana empieza a importar.
Los chats y los agentes son más complicados, porque la API reenvía todo el historial en cada llamada. Toma un agente que ejecuta 20 pasos, y cada paso añade unos 2.000 tokens de salida de herramientas y respuesta (una suposición para este ejemplo). El paso 1 envía 2.000 tokens, el paso 2 envía 4.000, el paso 20 envía 40.000. A lo largo de toda la ejecución envía 2.000 × 210 = 420.000 tokens, donde 210 es 1 + 2 + … + 20.
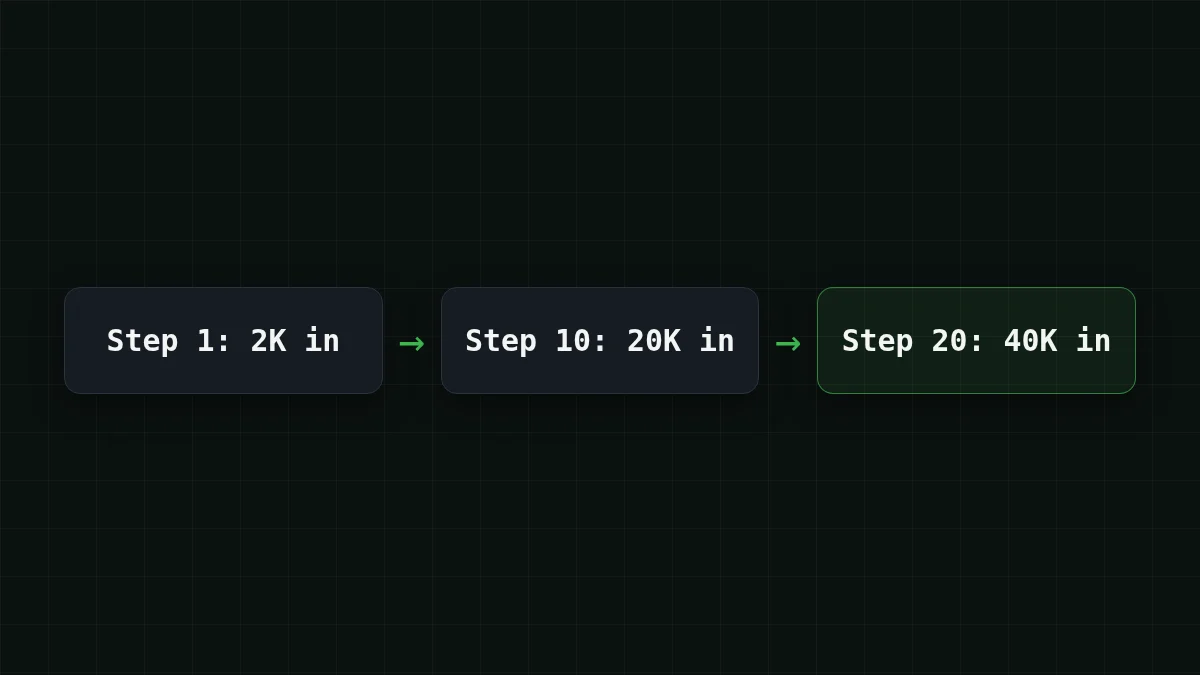
Aquí se esconden dos preguntas distintas. La ventana de contexto solo se preocupa por la solicitud individual más grande: 40.000 tokens en el paso 20, que cualquier modelo del catálogo contiene fácilmente. La factura se preocupa por el total, 420.000 tokens. Ten ambas en mente, y no elegirás un modelo por la razón equivocada.
Longitud de salida: el límite que corta las respuestas#
El límite de salida es un techo para una réplica, y es fácil olvidarlo hasta que una respuesta se detiene a mitad de frase. Una regla general para el inglés: un token es aproximadamente tres cuartos de una palabra. Pides un informe de 6000 palabras: 6000 / 0.75 = 8000 tokens. Eso apenas cabe por debajo de 8.192. Pide 7.000 palabras y el texto termina en medio de un párrafo.
Con un techo de 32.768 tokens la misma aritmética da 24576 palabras en una respuesta (32768 × 0.75 = 24576), así que código generado, informes largos y borradores de capítulos enteros caben en una sola réplica. Cuando una réplica sí se corta, la API te lo dice: finish_reason vuelve como length (por qué ocurre y cómo solucionarlo).
Verificación rápida
Le pides a un modelo con un límite de salida de 8.192 tokens un informe de 12.000 palabras. ¿Qué obtienes?
Mostrar respuesta
Respuesta: Un informe que se detiene a medias, con finish_reason establecido en length
12.000 palabras son unos 16.000 tokens, el doble del tope. El modelo escribe hasta chocar con el techo y se detiene, y la API marca la réplica con finish_.
Velocidad: el único número que mides tú mismo#
La velocidad son en realidad dos números: cuánto tarda en aparecer el primer texto, y cuán rápido fluye el resto. Ambos varían con la carga, la longitud del prompt y la hora del día, así que una cifra copiada de una tabla es una mala guía. Mídela con tu propio prompt. Esto toma un minuto y usa unos pocos tokens (la clave viene de una variable de entorno; consulta la documentación para crear una):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Obtienes una línea: first text after <N>s, finished after <M>s. Cambia el id del modelo por zai- o MiniMaxAI/, ejecuta cada uno unas cuantas veces, y tienes una comparación de velocidad para tu prompt. ¿Importa? Para un chat en vivo, sí: la gente nota una pausa antes de la primera palabra. Para un lote nocturno de resúmenes, nadie está mirando, y la velocidad baja al final de tu lista.
Precio: suma entrada y salida juntas#
Los precios se cotizan por millón de tokens, pero pagas por solicitud, y una solicitud tiene tanto un lado de entrada como un lado de salida. Así que compara modelos sobre una carga de trabajo, no sobre dos columnas. Digamos que tu bot de soporte gestiona 1.000 tickets al día, cada uno de unos 300 tokens de entrada y 150 de salida (una suposición; reemplázala con la tuya). La tabla es dinámica y se recalcula con los precios actuales:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 tokens de entrada y 150 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Lee el total, no las columnas. En total, con entrada y salida contadas juntas, cada uno de los tres sale más barato que el precio de referencia de OpenRouter en la columna OpenRouter de esa tabla.
Y aquí es donde los agentes muerden. La ejecución de 20 pasos de la sección de contexto envía 420.000 tokens de entrada y escribe quizá 4.000 de salida (200 por paso, de nuevo una suposición). En DeepSeek-V4-Flash una de esas ejecuciones cuesta $0.0067. ¿Cinco ejecuciones en un día? Mueve los deslizadores y observa los tres modelos:
Calculadora de costos
Un día de trabajo de agente: cinco tareas de 20 pasos
Tokens de entrada por solicitud: 21.000 · Tokens de salida por solicitud: 200 · Solicitudes por día: 100
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Los precios de los modelos siguen iguales a cualquier hora del día, así que un cálculo que hagas ahora sirve también para el lote de la noche. Para repasar por qué los tokens de salida suelen costar más que los de entrada, consulta tokens de entrada y salida.
Elige un modelo según la tarea#
Empieza por la tarea, encuentra el número que más muerde, y revisa los otros tres después. Haz clic en tu propio caso:
Elige tu caso
¿Qué modelo para mi tarea?
Elige una opción para ver la respuesta
Un bot de soporte con respuestas cortas
Las preguntas y respuestas son cortas, así que todos los modelos del catálogo tienen espacio de sobra, y la columna de precio decide. Pasa tu ticket típico por la tabla de costos de arriba y empieza con GLM-5.3-Flash o MiniMax-M2.7, el que mejor total dé para tus números.
Un asistente de programación que lee muchos archivos
El contexto va primero. GLM-5.3-Flash tiene la ventana más grande de los tres con 390K, DeepSeek-V4-Flash tiene 380K. MiniMax-M2.7 con 180K es suficiente cuando los archivos que envías juntos se mantienen bien por debajo de eso.
Un agente que itera sobre muchos pasos
El historial se reenvía en cada paso, así que el total crece rápido. DeepSeek-V4-Flash combina un contexto de 380K con hasta 32.768 tokens de salida por respuesta y un solo precio a cualquier hora, lo que mantiene predecibles los bucles largos. Comprueba el total con la calculadora de arriba.
Informes largos y código generado
La salida máxima decide. DeepSeek-V4-Flash escribe hasta 32.768 tokens por respuesta; GLM-5.3-Flash y MiniMax-M2.7 escriben hasta 8.192, lo que cubre un informe de unas 6.000 palabras.
Ningún modelo gana en todas las filas, por eso ayuda ejecutar los mismos diez prompts reales con dos candidatos antes de decidirte. La comparación GLM vs DeepSeek vs MiniMax profundiza en los tres modelos, y la página de precios siempre muestra los números actuales.


