Como escolher um modelo de IA: contexto, saída, velocidade, preço
Escolha um modelo para chat, programação ou agente com quatro números: janela de contexto, saída máxima, velocidade e preço. Exemplos práticos e uma tabela de custos dinâmica.
Nesta página
Uma lista de modelos com quarenta nomes, uma tarefa descrita em uma frase e nenhuma ligação óbvia entre os dois. Aqui está a resposta curta: verifique quatro números, nesta ordem. Janela de contexto e saída máxima decidem se um modelo consegue fazer sua tarefa. Velocidade e preço decidem quão agradável e quão caro é. Contexto, limite de saída e preço estão listados na página de modelos e na tabela de preços; a velocidade você mesmo mede em cerca de um minuto, e o script está abaixo.
Os quatro números em palavras simples#
Pense no modelo como um colega em uma mesa. A janela de contexto é o tamanho da mesa: tudo que precisa estar na frente dele ao mesmo tempo. A saída máxima é quanto tempo ele pode falar de uma vez. A velocidade é quão rápido ele começa a responder. O preço é o valor por hora. Quatro termos, e você vai encontrar todos eles em toda documentação de API:
Flashcards
Palavras que você vai encontrar em toda lista de modelos
Toque num cartão para virar
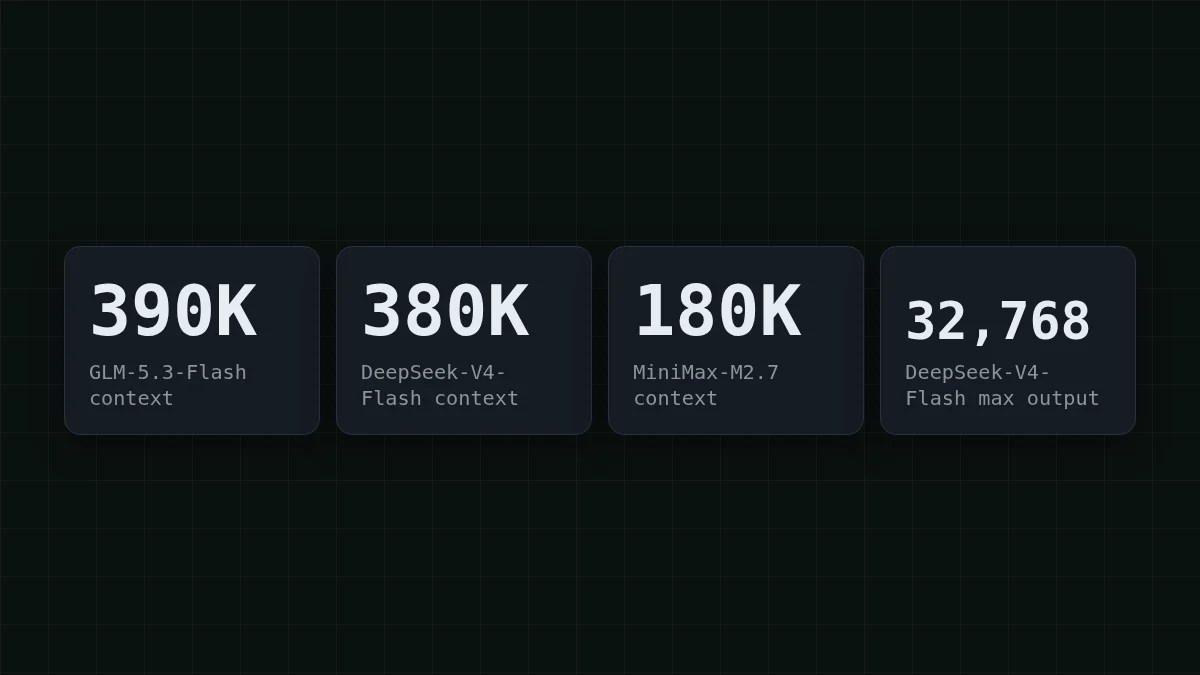
Para tornar isso concreto, aqui estão os dois primeiros números para os três modelos do catálogo CheapTokens, da referência de modelos CheapTokens (27 de outubro de 2026): GLM-5.3-Flash tem contexto de 390K e responde até 8.192 tokens; DeepSeek-V4-Flash (versão 0731) tem 380K e responde até 32.768 tokens; MiniMax-M2.7 tem 180K e responde até 8.192 tokens.
Contexto: tudo que você enviar vai caber?#
Digamos que seu assistente de programação abra 12 arquivos de cerca de 3.000 tokens cada, depois adicione sua pergunta e as próprias anotações. 12 × 3.000 = 36.000 tokens. Até a menor janela acima, 180K, comporta isso com bastante folga. Um único arquivo enorme ou um dump de repositório inteiro é onde a janela começa a importar.
Chats e agentes são mais complicados, porque a API reenvia todo o histórico a cada chamada. Considere um agente que executa 20 passos, e cada passo adiciona cerca de 2.000 tokens de saída de ferramenta e resposta (uma suposição para este exemplo). O passo 1 envia 2.000 tokens, o passo 2 envia 4.000, o passo 20 envia 40.000. Ao longo de toda a execução, ele envia 2.000 × 210 = 420.000 tokens, onde 210 é 1 + 2 + … + 20.
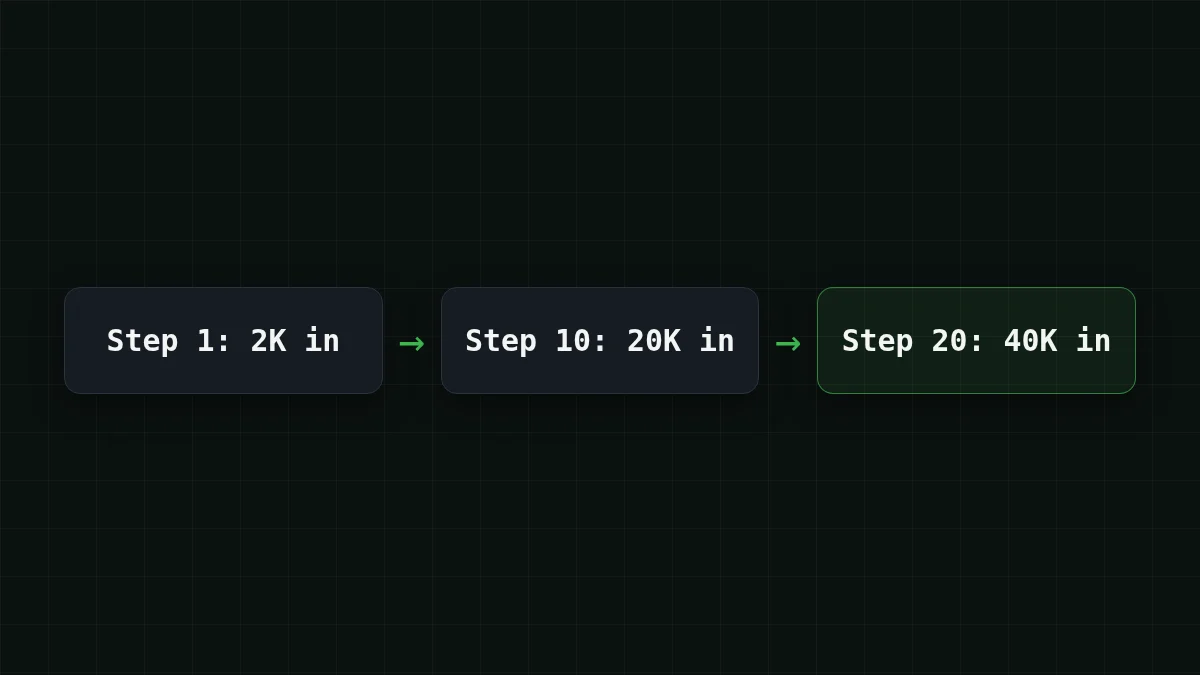
Duas perguntas diferentes se escondem aqui. A janela de contexto se importa apenas com a maior requisição única: 40.000 tokens no passo 20, o que todo modelo do catálogo comporta facilmente. A conta se importa com o total, 420.000 tokens. Mantenha os dois em mente, e você não escolherá um modelo pelo motivo errado.
Comprimento da saída: o limite que corta respostas#
O limite de saída é um teto para uma resposta, e é fácil esquecer até que uma resposta pare no meio da frase. Uma regra prática para inglês: um token é cerca de três quartos de uma palavra. Você pede um relatório de 6000 palavras: 6000 / 0,75 = 8000 tokens. Isso cabe exatamente abaixo de 8.192. Peça 7.000 palavras e o texto termina no meio de um parágrafo.
Com um teto de 32.768 tokens, a mesma aritmética resulta em 24576 palavras em uma resposta (32768 × 0,75 = 24576), então código gerado, relatórios longos e rascunhos de capítulos inteiros cabem em uma única resposta. Quando uma resposta é cortada, a API avisa: finish_reason volta como length (por que isso acontece e como corrigir).
Verificação rápida
Você pede a um modelo com limite de saída de 8.192 tokens um relatório de 12.000 palavras. O que você recebe?
Mostrar resposta
Resposta: Um relatório que para no meio, com finish_reason definido como length
12.000 palavras são cerca de 16.000 tokens, o dobro do teto. O modelo escreve até atingir o teto e para, e a API marca a resposta com finish_.
Velocidade: o número que você mesmo mede#
Velocidade são na verdade dois números: quanto tempo até o primeiro texto aparecer, e quão rápido o restante chega em streaming. Ambos variam com carga, comprimento do prompt e hora do dia, então um número copiado de uma tabela é um guia ruim. Meça com seu próprio prompt. Isso leva um minuto e usa alguns tokens (a chave vem de uma variável de ambiente; veja a documentação para criar uma):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Você recebe uma linha: first text after <N>s, finished after <M>s. Troque o id do modelo por zai- ou MiniMaxAI/, execute cada um algumas vezes, e você tem uma comparação de velocidade para seu prompt. Isso importa? Para um chat ao vivo, sim: as pessoas percebem uma pausa antes da primeira palavra. Para um lote noturno de resumos, ninguém está olhando, e a velocidade cai para o fim da sua lista.
Preço: some entrada e saída#
Os preços são cotados por milhão de tokens, mas você paga por requisição, e uma requisição tem tanto um lado de entrada quanto um lado de saída. Então compare modelos em uma carga de trabalho, não em duas colunas. Digamos que seu bot de suporte lida com 1.000 tickets por dia, cada um com cerca de 300 tokens de entrada e 150 de saída (uma suposição; substitua pelos seus próprios números). A tabela é dinâmica e recalcula com os preços atuais:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 tokens de entrada e 150 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Leia o total, não as colunas. No total, com entrada e saída contadas juntas, cada um dos três sai mais barato que o preço de referência do OpenRouter na coluna OpenRouter dessa tabela.
E aqui é onde os agentes pesam. A execução de 20 passos da seção de contexto envia 420.000 tokens de entrada e escreve talvez 4.000 de saída (200 por passo, novamente uma suposição). No DeepSeek-V4-Flash, uma execução dessas custa $0.0067. Cinco execuções em um dia? Mova os controles e observe os três modelos:
Calculadora de custos
Um dia de trabalho de agente: cinco tarefas de 20 passos
Tokens de entrada por solicitação: 21.000 · Tokens de saída por solicitação: 200 · Solicitações por dia: 100
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Os preços dos modelos permanecem os mesmos em qualquer hora do dia, então um cálculo que você faz agora vale para o lote da noite também. Para relembrar por que tokens de saída geralmente custam mais que os de entrada, veja tokens de entrada e saída.
Escolha um modelo por tarefa#
Comece pela tarefa, encontre o número que mais pesa, e verifique os outros três depois. Clique no seu próprio caso:
Escolha o seu caso
Qual modelo para minha tarefa?
Escolha uma opção para ver a resposta
Um bot de suporte com respostas curtas
Perguntas e respostas são curtas, então todo modelo do catálogo tem folga de sobra, e a coluna de preço decide. Rode seu ticket típico pela tabela de custos acima e comece com GLM-5.3-Flash ou MiniMax-M2.7, o que tiver o melhor total para seus números.
Um assistente de programação que lê muitos arquivos
Contexto vem primeiro. GLM-5.3-Flash tem a maior janela dos três, com 390K, DeepSeek-V4-Flash tem 380K. MiniMax-M2.7 com 180K é suficiente quando os arquivos que você envia juntos ficam bem abaixo disso.
Um agente que faz loop por muitos passos
O histórico é reenviado a cada passo, então o total cresce rápido. DeepSeek-V4-Flash combina um contexto de 380K com até 32.768 tokens de saída por resposta e um preço a qualquer hora, o que mantém loops longos previsíveis. Verifique o total com a calculadora acima.
Relatórios longos e código gerado
A saída máxima decide. DeepSeek-V4-Flash escreve até 32.768 tokens por resposta; GLM-5.3-Flash e MiniMax-M2.7 escrevem até 8.192, o que cobre um relatório de cerca de 6.000 palavras.
Nenhum modelo vence todas as linhas, e é por isso que ajuda rodar os mesmos dez prompts reais por dois candidatos antes de decidir. A comparação GLM vs DeepSeek vs MiniMax aprofunda os três modelos, e a página de preços sempre mostra os números atuais.


