KI für EinsteigerAnleitung
Wie man ein KI-Modell auswählt: Kontext, Ausgabe, Geschwindigkeit, Preis
Wähle ein Modell für Chat, Coding oder einen Agenten anhand von vier Zahlen: Kontextfenster, maximale Ausgabe, Geschwindigkeit und Preis. Durchgerechnete Beispiele und eine Live-Kostentabelle.
Auf dieser Seite
Eine Modellliste mit vierzig Namen, eine in einem Satz beschriebene Aufgabe und kein offensichtlicher Zusammenhang zwischen beiden. Hier die kurze Antwort: Prüfe vier Zahlen, in dieser Reihenfolge. Kontextfenster und maximale Ausgabe entscheiden, ob ein Modell deine Aufgabe überhaupt bewältigen kann. Geschwindigkeit und Preis entscheiden, wie angenehm und wie teuer es ist. Kontext, Ausgabelimit und Preis stehen auf der Modellseite und in der Preistabelle; die Geschwindigkeit misst du selbst in etwa einer Minute, das Skript findest du unten.
Die vier Zahlen in einfachen Worten#
Stell dir das Modell als Kollegen an einem Schreibtisch vor. Das Kontextfenster ist die Größe des Schreibtischs: alles, was gleichzeitig vor ihm liegen muss. Die maximale Ausgabe ist, wie lange er am Stück sprechen kann. Die Geschwindigkeit ist, wie schnell er mit der Antwort beginnt. Der Preis ist sein Stundensatz. Vier Begriffe, und du wirst ihnen in jeder API-Dokumentation begegnen:
Lernkarten
Begriffe, die dir in jeder Modellliste begegnen
Tippe auf eine Karte, um sie umzudrehen
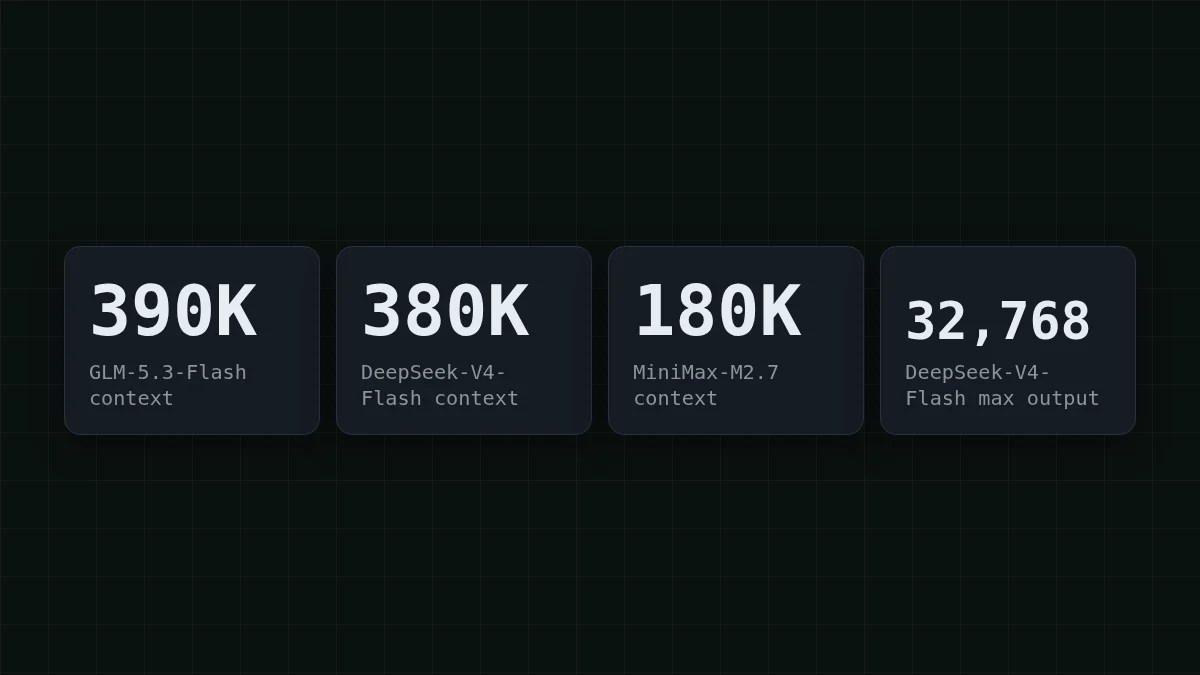
Um das konkret zu machen, hier die ersten beiden Zahlen für die drei Modelle im CheapTokens-Katalog, aus der CheapTokens-Modellreferenz (27. Oktober 2026): GLM-5.3-Flash hat ein 390K-Kontextfenster und antwortet mit bis zu 8.192 Token; DeepSeek-V4-Flash (Release 0731) hat 380K und antwortet mit bis zu 32.768 Token; MiniMax-M2.7 hat 180K und antwortet mit bis zu 8.192 Token.
Kontext: Passt alles hinein, was du sendest?#
Angenommen, dein Coding-Assistent öffnet 12 Dateien mit je etwa 3.000 Token und fügt dann deine Frage und seine eigenen Notizen hinzu. 12 × 3.000 = 36.000 Token. Selbst das kleinste Fenster oben, 180K, bietet dafür reichlich Platz. Bei einer einzelnen riesigen Datei oder einem vollständigen Repository-Dump wird das Fenster relevant.
Chats und Agenten sind kniffliger, weil die API bei jedem Aufruf den gesamten Verlauf erneut sendet. Nimm einen Agenten, der 20 Schritte ausführt, und jeder Schritt fügt etwa 2.000 Token an Tool-Ausgabe und Antwort hinzu (eine Annahme für dieses Beispiel). Schritt 1 sendet 2.000 Token, Schritt 2 sendet 4.000, Schritt 20 sendet 40.000. Über den gesamten Lauf sendet er 2.000 × 210 = 420.000 Token, wobei 210 = 1 + 2 + … + 20 ist.
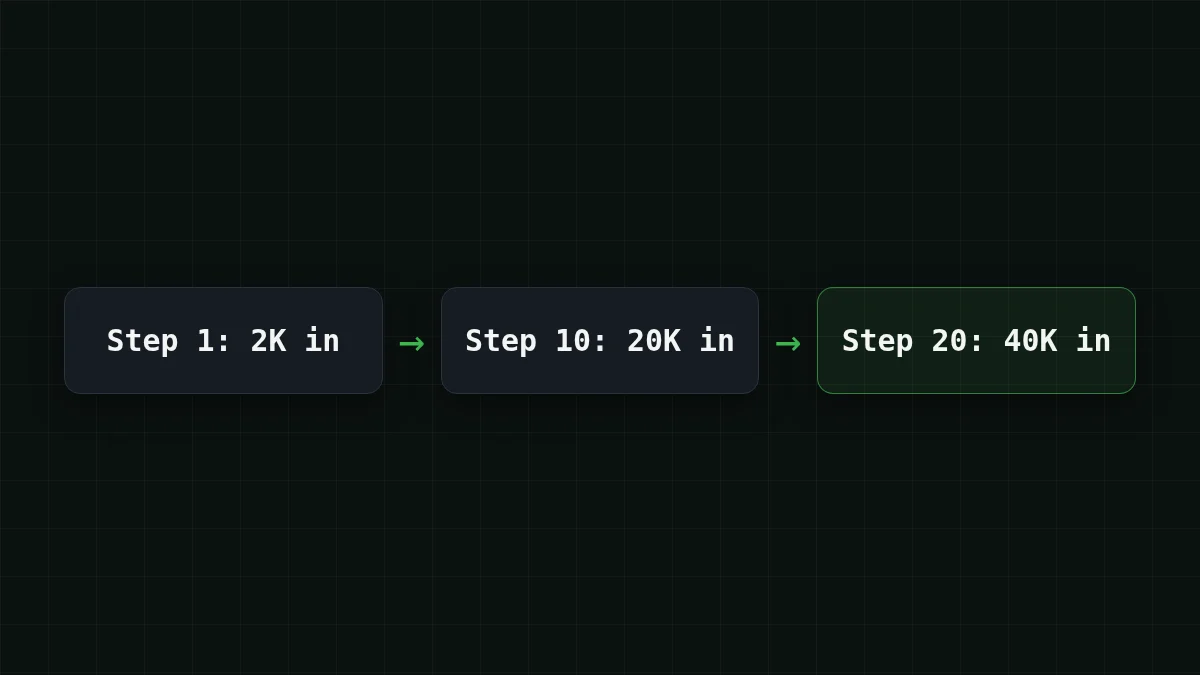
Hier verbergen sich zwei verschiedene Fragen. Das Kontextfenster betrifft nur die größte einzelne Anfrage: 40.000 Token bei Schritt 20, was jedes Modell im Katalog problemlos bewältigt. Die Rechnung betrifft die Gesamtsumme, 420.000 Token. Behalte beides im Kopf, dann wählst du kein Modell aus dem falschen Grund.
Ausgabelänge: das Limit, das Antworten abschneidet#
Das Ausgabelimit ist eine Obergrenze für eine Antwort, und man vergisst es leicht, bis eine Antwort mitten im Satz endet. Eine Faustregel für Englisch: Ein Token entspricht etwa drei Vierteln eines Wortes. Du forderst einen Bericht von 6000 Wörtern an: 6000 / 0,75 = 8000 Token. Das passt gerade noch unter 8.192. Fordere 7.000 Wörter an, und der Text endet mitten in einem Absatz.
Mit einer Obergrenze von 32.768 Token ergibt dieselbe Rechnung 24576 Wörter in einer Antwort (32768 × 0,75 = 24576), sodass generierter Code, lange Berichte und Entwürfe ganzer Kapitel in eine einzige Antwort passen. Wenn eine Antwort doch abgeschnitten wird, teilt dir die API das mit: finish_reason kommt als length zurück (warum das passiert und wie man es behebt).
Kurzer Check
Du bittest ein Modell mit einem Ausgabelimit von 8.192 Token um einen Bericht von 12.000 Wörtern. Was bekommst du?
Antwort anzeigen
Antwort: Einen Bericht, der mittendrin abbricht, mit finish_reason auf length gesetzt
12.000 Wörter sind etwa 16.000 Token, doppelt so viel wie die Obergrenze. Das Modell schreibt, bis es die Obergrenze erreicht, und hört dann auf, und die API markiert die Antwort mit finish_.
Geschwindigkeit: die eine Zahl, die du selbst misst#
Geschwindigkeit sind eigentlich zwei Zahlen: wie lange es dauert, bis der erste Text erscheint, und wie schnell der Rest hereinkommt. Beide ändern sich mit Last, Prompt-Länge und Tageszeit, daher ist ein aus einer Tabelle kopierter Wert ein schlechter Anhaltspunkt. Miss es mit deinem eigenen Prompt. Das dauert eine Minute und verbraucht ein paar Token (der Schlüssel kommt aus einer Umgebungsvariable; siehe Dokumentation zum Erstellen eines solchen):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Du bekommst eine Zeile: first text after <N>s, finished after <M>s. Tausche die Modell-ID gegen zai- oder MiniMaxAI/ aus, führe jedes ein paar Mal aus, und du hast einen Geschwindigkeitsvergleich für deinen Prompt. Ist das wichtig? Für einen Live-Chat ja: Menschen bemerken eine Pause vor dem ersten Wort. Bei einem nächtlichen Stapel von Zusammenfassungen schaut niemand zu, und die Geschwindigkeit rutscht ans Ende deiner Liste.
Preis: Eingabe und Ausgabe zusammenzählen#
Preise werden pro Million Token angegeben, aber du zahlst pro Anfrage, und eine Anfrage hat sowohl eine Eingabeseite als auch eine Ausgabeseite. Vergleiche Modelle also anhand einer Arbeitslast, nicht anhand von zwei Spalten. Angenommen, dein Support-Bot bearbeitet 1.000 Tickets pro Tag, jedes etwa 300 Token Eingabe und 150 Ausgabe (eine Annahme; ersetze sie durch deine eigenen). Die Tabelle ist live und berechnet sich aus aktuellen Preisen neu:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 Input- und 150 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Lies die Summe, nicht die Spalten. In der Summe, mit Eingabe und Ausgabe zusammengerechnet, ist jedes der drei günstiger als OpenRouters Referenzpreis in der OpenRouter-Spalte dieser Tabelle.
Und hier schlagen Agenten zu. Der 20-Schritte-Lauf aus dem Kontextabschnitt sendet 420.000 Token Eingabe und schreibt vielleicht 4.000 Ausgabe (200 pro Schritt, wieder eine Annahme). Bei DeepSeek-V4-Flash kostet ein solcher Lauf $0.0067. Fünf Läufe an einem Tag? Verschiebe die Schieberegler und beobachte die drei Modelle:
Kostenrechner
Ein Tag Agentenarbeit: fünf 20-Schritte-Aufgaben
Eingabe-Tokens pro Anfrage: 21.000 · Ausgabe-Tokens pro Anfrage: 200 · Anfragen pro Tag: 100
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Die Modellpreise bleiben zu jeder Tageszeit gleich, eine jetzt durchgeführte Berechnung gilt also auch für den abendlichen Stapel. Eine Auffrischung, warum Ausgabe-Token normalerweise mehr kosten als Eingabe, findest du unter Eingabe- und Ausgabe-Token.
Wähle ein Modell nach Aufgabe#
Beginne bei der Aufgabe, finde die Zahl, die am stärksten einschränkt, und prüfe danach die anderen drei. Klicke dich durch deinen eigenen Fall:
Wähle deinen Fall
Welches Modell für meine Aufgabe?
Wähle eine Option, um die Antwort zu sehen
Ein Support-Bot mit kurzen Antworten
Fragen und Antworten sind kurz, jedes Modell im Katalog hat also reichlich Platz, und die Preisspalte entscheidet. Lass dein typisches Ticket durch die Kostentabelle oben laufen und beginne mit GLM-5.3-Flash oder MiniMax-M2.7, je nachdem, welche Summe für deine Zahlen besser aussieht.
Ein Coding-Assistent, der viele Dateien liest
Der Kontext kommt zuerst. GLM-5.3-Flash hat das größte Fenster der drei mit 390K, DeepSeek-V4-Flash hat 380K. MiniMax-M2.7 mit 180K reicht aus, wenn die Dateien, die du zusammen sendest, deutlich darunter bleiben.
Ein Agent, der über viele Schritte läuft
Der Verlauf wird bei jedem Schritt erneut gesendet, die Gesamtsumme wächst also schnell. DeepSeek-V4-Flash kombiniert ein 380K-Kontextfenster mit bis zu 32.768 Ausgabe-Token pro Antwort und einem Preis zu jeder Stunde, was lange Schleifen berechenbar macht. Prüfe die Summe mit dem Rechner oben.
Lange Berichte und generierter Code
Die maximale Ausgabe entscheidet. DeepSeek-V4-Flash schreibt bis zu 32.768 Token pro Antwort; GLM-5.3-Flash und MiniMax-M2.7 schreiben bis zu 8.192, was einen Bericht von etwa 6.000 Wörtern abdeckt.
Kein einzelnes Modell gewinnt jede Zeile, deshalb hilft es, dieselben zehn echten Prompts durch zwei Kandidaten laufen zu lassen, bevor du dich festlegst. Der Vergleich GLM vs. DeepSeek vs. MiniMax geht tiefer auf die drei Modelle ein, und die Preisseite zeigt immer die aktuellen Zahlen.


