Yeni başlayanlar için AIKılavuz
Bir AI modeli nasıl seçilir: bağlam, çıktı, hız, fiyat
Sohbet, kodlama veya bir ajan için dört sayıyla model seçin: bağlam penceresi, maksimum çıktı, hız ve fiyat. Çözümlü örnekler ve canlı maliyet tablosu.
Bu sayfada
Kırk isimli bir model listesi, tek cümleyle anlatılan bir görev ve ikisi arasında belirgin bir bağ yok. Kısa cevap şu: dört sayıyı, bu sırayla kontrol edin. Bağlam penceresi ve maksimum çıktı bir modelin görevinizi yapıp yapamayacağını belirler. Hız ve fiyat ise ne kadar keyifli ve ne kadar pahalı olduğunu belirler. Bağlam, çıktı sınırı ve fiyat modeller sayfasında ve fiyatlandırma tablosunda listelenir; hızı ise yaklaşık bir dakikada kendiniz kontrol edersiniz, betik aşağıda.
Dört sayı, sade bir dille#
Modeli masada oturan bir iş arkadaşı gibi düşünün. Bağlam penceresi masanın büyüklüğüdür: aynı anda önünde olması gereken her şey. Maksimum çıktı, tek seferde ne kadar konuşabileceğidir. Hız, yanıt vermeye ne kadar çabuk başladığıdır. Fiyat ise saatlik ücretidir. Dört terim ve her API dokümanında bunların hepsiyle karşılaşacaksınız:
Bilgi kartları
Her model listesinde karşılaşacağınız terimler
Çevirmek için bir karta dokun
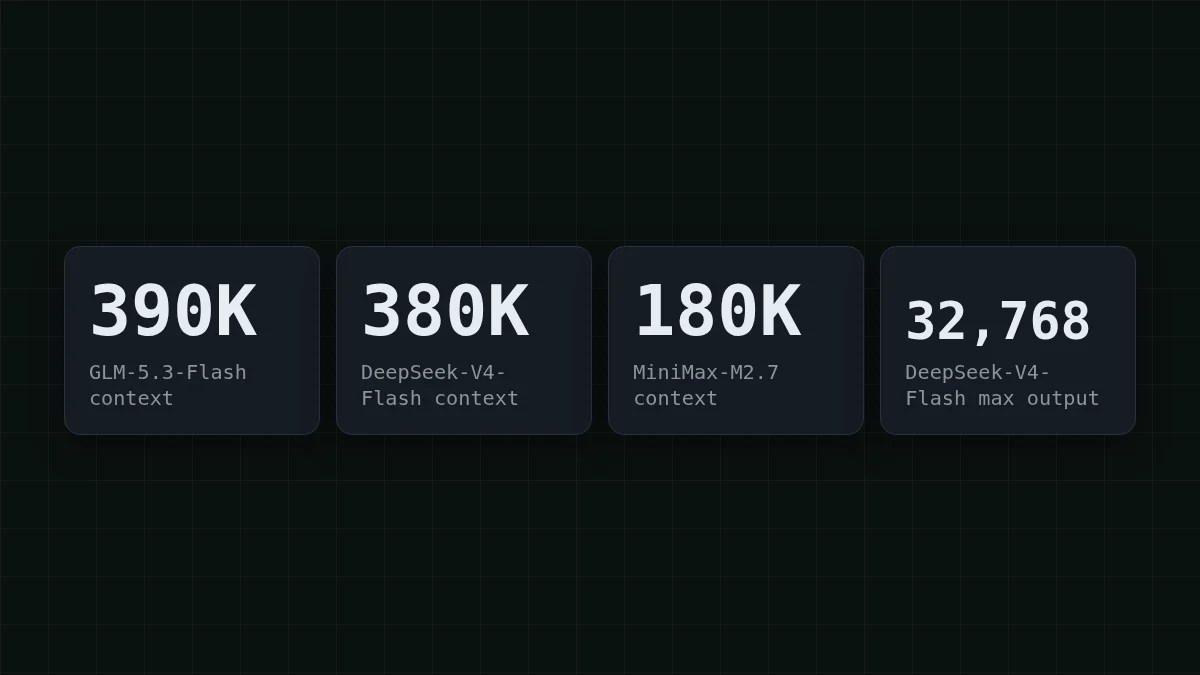
Bunu somutlaştırmak için, CheapTokens kataloğundaki üç modelin ilk iki sayısı, CheapTokens model referansından (27 Ekim 2026): GLM-5.3-Flash 390K bağlama sahip ve 8.192 token'a kadar yanıtlıyor; DeepSeek-V4-Flash (sürüm 0731) 380K'ya sahip ve 32.768 token'a kadar yanıtlıyor; MiniMax-M2.7 180K'ya sahip ve 8.192 token'a kadar yanıtlıyor.
Bağlam: gönderdiğiniz her şey sığacak mı?#
Kodlama asistanınızın her biri yaklaşık 3.000 token olan 12 dosya açtığını, ardından sorunuzu ve kendi notlarını eklediğini varsayalım. 12 × 3.000 = 36.000 token. Yukarıdaki en küçük pencere olan 180K bile bunu bolca alır. Tek bir dev dosya veya tüm bir depo dökümü, pencerenin önem kazandığı yerdir.
Sohbetler ve ajanlar daha zordur, çünkü API her çağrıda tüm geçmişi yeniden gönderir. 20 adım çalışan bir ajan düşünün ve her adım yaklaşık 2.000 token araç çıktısı ve yanıt ekliyor (bu örnek için bir varsayım). 1. adım 2.000 token gönderir, 2. adım 4.000, 20. adım 40.000. Tüm çalışma boyunca 2.000 × 210 = 420.000 token gönderir; burada 210, 1 + 2 + … + 20'dir.
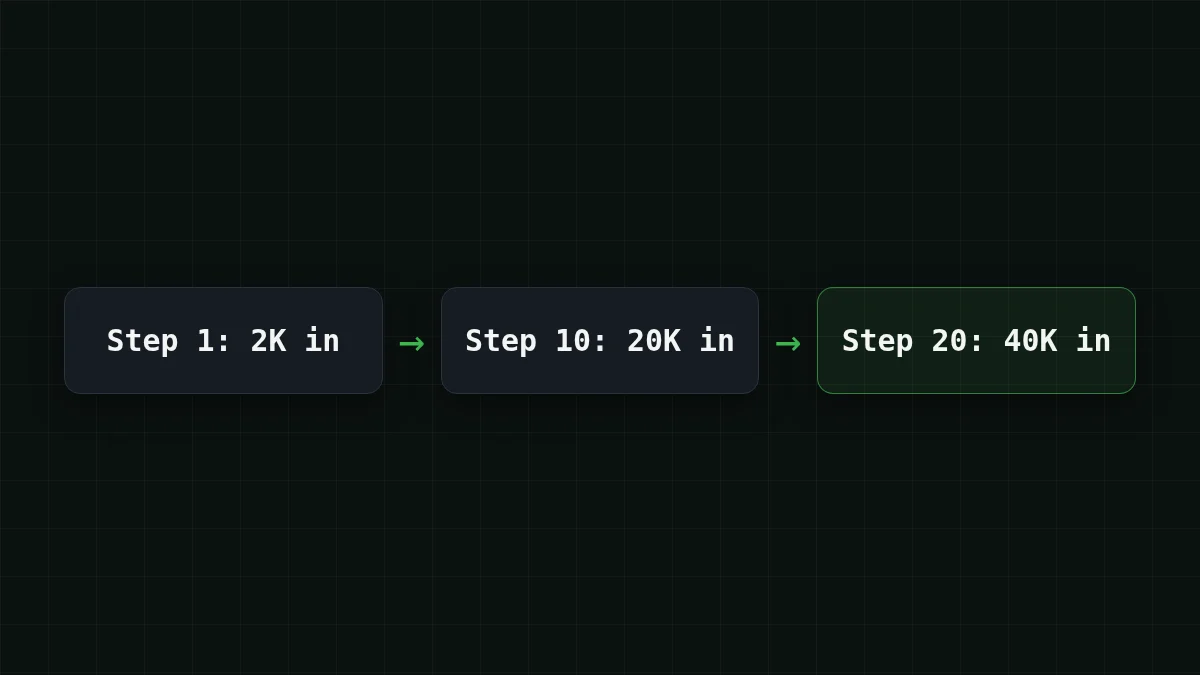
Burada iki farklı soru gizlidir. Bağlam penceresi yalnızca en büyük tek isteği önemser: 20. adımda 40.000 token, ki katalogdaki her model bunu kolayca alır. Fatura ise toplamı önemser: 420.000 token. İkisini de aklınızda tutun, o zaman yanlış nedenle model seçmezsiniz.
Çıktı uzunluğu: yanıtları kısa kesen sınır#
Çıktı sınırı tek bir yanıt için bir tavandır ve bir yanıt cümle ortasında durana kadar bunu unutmak kolaydır. İngilizce için pratik bir kural: bir token yaklaşık bir kelimenin dörtte üçüdür. 6000 kelimelik bir rapor istiyorsunuz: 6000 / 0.75 = 8000 token. Bu tam olarak 8.192'nin altına sığar. 7.000 kelime isterseniz metin bir paragrafın ortasında biter.
32.768 token'lık bir tavanla aynı aritmetik tek bir yanıtta 24576 kelimeye denk gelir (32768 × 0.75 = 24576), böylece üretilen kod, uzun raporlar ve tüm bölüm taslakları tek bir yanıta sığar. Bir yanıt kesildiğinde API size söyler: finish_reason, length olarak döner (bunun neden olduğu ve nasıl düzeltileceği).
Hızlı kontrol
8.192 token çıktı sınırı olan bir modelden 12.000 kelimelik bir rapor istiyorsunuz. Ne alırsınız?
Cevabı göster
Cevap: Yarıda duran, finish_reason değeri length olarak ayarlanmış bir rapor
12.000 kelime yaklaşık 16.000 tokendır, tavanın iki katı. Model tavana ulaşana kadar yazar ve durur, API de yanıtı finish_ ile işaretler.
Hız: kendiniz ölçtüğünüz tek sayı#
Hız aslında iki sayıdır: ilk metnin görünmesine kadar geçen süre ve geri kalanın ne kadar hızlı aktığı. İkisi de yüke, istem uzunluğuna ve günün saatine göre değişir, bu yüzden bir tablodan kopyalanan rakam kötü bir rehberdir. Kendi isteminizde ölçün. Bu bir dakika sürer ve birkaç token kullanır (anahtar bir ortam değişkeninden gelir; oluşturmak için dokümanlara bakın):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Tek bir satır alırsınız: first text after <N>s, finished after <M>s. Model kimliğini zai- veya MiniMaxAI/ ile değiştirin, her birini birkaç kez çalıştırın ve isteminiz için bir hız karşılaştırmanız olur. Önemli mi? Canlı bir sohbet için evet: insanlar ilk kelimeden önceki duraklamayı fark eder. Gecelik bir özet toplu işi için kimse izlemiyor ve hız listenizin en altına düşer.
Fiyat: girdi ve çıktıyı toplayın#
Fiyatlar milyon token başına verilir, ancak istek başına ödersiniz ve bir isteğin hem girdi tarafı hem de çıktı tarafı vardır. Bu yüzden modelleri iki sütun üzerinden değil, bir iş yükü üzerinden karşılaştırın. Destek botunuzun günde 1.000 bilet işlediğini, her birinin yaklaşık 300 token girdi ve 150 çıktı olduğunu varsayalım (bir varsayım; kendi değerlerinizle değiştirin). Tablo canlıdır ve güncel fiyatlardan yeniden hesaplanır:
| Model | Giriş $/1M | Çıkış $/1M | İstek başına | 1.000 istek | OpenRouter, 1.000 istek |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
İstek başına 300 giriş ve 150 çıkış token'ı. 1M token başına fiyatlar günceldir ve tarifelerimizle birlikte değişir; OpenRouter sütunu aynı iş yükü için referans fiyatları gösterir.
Sütunları değil, toplamı okuyun. Toplamda, girdi ve çıktı birlikte sayıldığında, üçünün her biri o tablonun OpenRouter sütunundaki OpenRouter referans fiyatından daha ucuza gelir.
Ve ajanların can yaktığı yer burasıdır. Bağlam bölümündeki 20 adımlı çalışma 420.000 token gönderir ve belki 4.000 yazar (adım başına 200, yine bir varsayım). DeepSeek-V4-Flash'te böyle bir çalışma $0.0067 tutar. Günde beş çalışma mı? Kaydırıcıları hareket ettirin ve üç modeli izleyin:
Maliyet hesaplayıcı
Bir günlük ajan işi: beş adet 20 adımlı görev
İstek başına giriş token'ı: 21.000 · İstek başına çıkış token'ı: 200 · Günlük istek sayısı: 100
| Model | Günlük | Aylık |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Model fiyatları günün her saatinde aynı kalır, bu yüzden şimdi yaptığınız bir hesaplama akşamki toplu iş için de geçerlidir. Çıktı token'larının neden genellikle girdiden daha pahalı olduğunu tazelemek için girdi ve çıktı token'ları sayfasına bakın.
Göreve göre model seçin#
Görevden başlayın, en çok can yakan sayıyı bulun ve diğer üçünü sonra kontrol edin. Kendi durumunuz için tıklayın:
Durumunu seç
Görevim için hangi model?
Cevabı görmek için bir seçenek seçin
Kısa yanıtlı bir destek botu
Sorular ve yanıtlar kısadır, bu yüzden katalogdaki her modelin bolca yeri vardır ve fiyat sütunu belirler. Tipik biletinizi yukarıdaki maliyet tablosundan geçirin ve kendi sayılarınız için hangisinin toplamı daha iyi görünüyorsa GLM-5.3-Flash veya MiniMax-M2.7 ile başlayın.
Birçok dosya okuyan bir kodlama asistanı
Önce bağlam gelir. GLM-5.3-Flash üçü arasında 390K ile en büyük pencereye sahiptir, DeepSeek-V4-Flash 380K'ya sahiptir. MiniMax-M2.7'nin 180K'sı, birlikte gönderdiğiniz dosyalar bunun oldukça altında kaldığında yeterlidir.
Birçok adımda dönen bir ajan
Geçmiş her adımda yeniden gönderilir, bu yüzden toplam hızla büyür. DeepSeek-V4-Flash, 380K bağlamı yanıt başına 32.768 çıktı token'ına kadar ve günün her saatinde tek bir fiyatla birleştirir, bu da uzun döngüleri öngörülebilir kılar. Toplamı yukarıdaki hesaplayıcıyla kontrol edin.
Uzun raporlar ve üretilen kod
Maks. çıktı belirler. DeepSeek-V4-Flash yanıt başına 32.768 token'a kadar yazar; GLM-5.3-Flash ve MiniMax-M2.7 8.192'ye kadar yazar, bu da yaklaşık 6.000 kelimelik bir raporu kapsar.
Hiçbir model her satırı kazanmaz, bu yüzden karar vermeden önce aynı on gerçek istemi iki aday üzerinden çalıştırmak yardımcı olur. GLM vs DeepSeek vs MiniMax karşılaştırması üç modelde daha derine iner ve fiyatlandırma sayfası her zaman güncel sayıları gösterir.


