AI untuk pemulaPanduan
Cara memilih model AI: context, output, kecepatan, harga
Pilih model untuk chat, coding, atau agen dengan empat angka: context window, max output, kecepatan, dan harga. Contoh nyata dan tabel biaya langsung.
Di halaman ini
Daftar model dengan empat puluh nama, tugas yang dijelaskan dalam satu kalimat, dan tidak ada kaitan yang jelas antara keduanya. Inilah jawaban singkatnya: periksa empat angka, dalam urutan ini. Context window dan maximum output menentukan apakah sebuah model bisa mengerjakan tugas Anda sama sekali. Kecepatan dan harga menentukan seberapa nyaman dan seberapa mahal. Context, batas output, dan harga tercantum di halaman model dan di tabel harga; kecepatan Anda ukur sendiri dalam sekitar satu menit, dan skripnya ada di bawah.
Empat angka dalam kata sederhana#
Bayangkan model sebagai rekan kerja di meja. Context window adalah ukuran mejanya: segala hal yang harus ada di hadapannya sekaligus. Maximum output adalah seberapa lama ia bisa berbicara dalam satu kali jalan. Kecepatan adalah seberapa cepat ia mulai menjawab. Harga adalah tarif per jamnya. Empat istilah, dan Anda akan menemui semuanya di setiap dokumentasi API:
Kartu kilat
Istilah yang akan Anda temui di setiap daftar model
Ketuk kartu untuk membaliknya
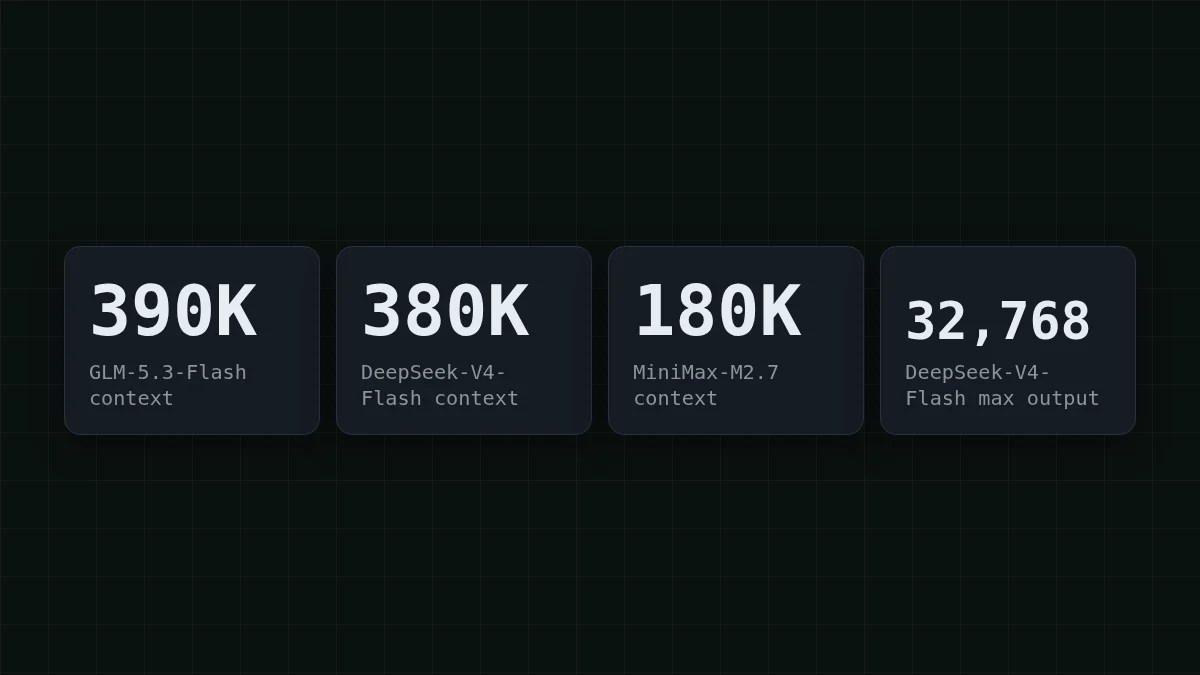
Untuk membuatnya konkret, berikut dua angka pertama untuk tiga model di katalog CheapTokens, dari referensi model CheapTokens (27 Oktober 2026): GLM-5.3-Flash memiliki context 390K dan menjawab hingga 8.192 token; DeepSeek-V4-Flash (rilis 0731) memiliki 380K dan menjawab hingga 32.768 token; MiniMax-M2.7 memiliki 180K dan menjawab hingga 8.192 token.
Context: apakah semua yang Anda kirim akan muat?#
Misalkan asisten coding Anda membuka 12 file masing-masing sekitar 3.000 token, lalu menambahkan pertanyaan Anda dan catatannya sendiri. 12 × 3.000 = 36.000 token. Bahkan window terkecil di atas, 180K, menampungnya dengan banyak ruang tersisa. Satu file raksasa atau seluruh dump repositori adalah saat window mulai berpengaruh.
Chat dan agen lebih rumit, karena API mengirim ulang seluruh riwayat pada setiap panggilan. Ambil contoh agen yang menjalankan 20 langkah, dan setiap langkah menambahkan sekitar 2.000 token output tool dan balasan (asumsi untuk contoh ini). Langkah 1 mengirim 2.000 token, langkah 2 mengirim 4.000, langkah 20 mengirim 40.000. Sepanjang seluruh proses ia mengirim 2.000 × 210 = 420.000 token, di mana 210 adalah 1 + 2 + … + 20.
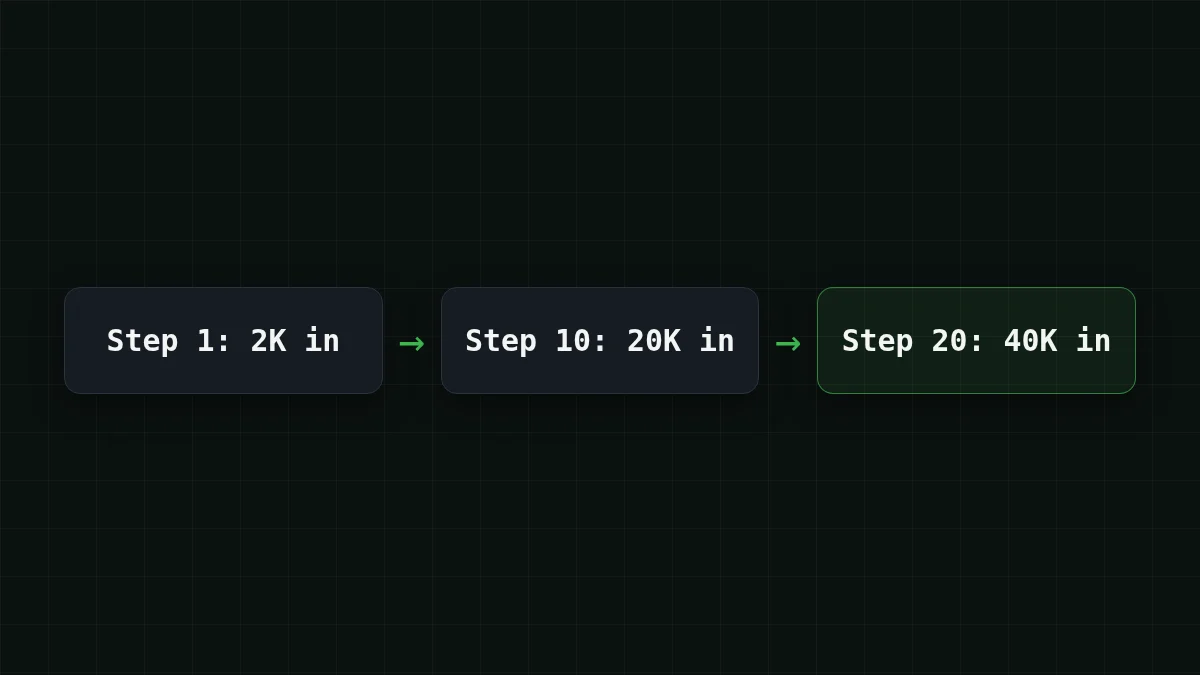
Dua pertanyaan berbeda tersembunyi di sini. Context window hanya peduli pada permintaan tunggal terbesar: 40.000 token pada langkah 20, yang ditampung dengan mudah oleh setiap model di katalog. Tagihan peduli pada totalnya, 420.000 token. Ingat keduanya, dan Anda tidak akan memilih model karena alasan yang salah.
Panjang output: batas yang memotong jawaban#
Batas output adalah plafon untuk satu balasan, dan mudah dilupakan sampai sebuah jawaban berhenti di tengah kalimat. Aturan praktis untuk bahasa Inggris: satu token sekitar tiga perempat kata. Anda meminta laporan 6000 kata: 6000 / 0,75 = 8000 token. Itu tepat muat di bawah 8.192. Minta 7.000 kata dan teksnya berakhir di tengah paragraf.
Dengan plafon 32.768 token, aritmetika yang sama menghasilkan 24576 kata dalam satu jawaban (32768 × 0,75 = 24576), sehingga kode yang dihasilkan, laporan panjang, dan draf seluruh bab muat dalam satu balasan. Ketika sebuah balasan memang terpotong, API memberi tahu Anda: finish_reason kembali sebagai length (mengapa itu terjadi dan cara memperbaikinya).
Cek cepat
Anda meminta laporan 12.000 kata kepada model dengan batas output 8.192 token. Apa yang Anda dapatkan?
Tampilkan jawaban
Jawaban: Laporan yang berhenti di tengah, dengan finish_reason diset ke length
12.000 kata sekitar 16.000 token, dua kali lipat plafonnya. Model menulis sampai mencapai plafon lalu berhenti, dan API menandai balasan dengan finish_.
Kecepatan: satu angka yang Anda ukur sendiri#
Kecepatan sebenarnya adalah dua angka: berapa lama sampai teks pertama muncul, dan seberapa cepat sisanya mengalir masuk. Keduanya berubah mengikuti beban, panjang prompt, dan waktu dalam sehari, jadi angka yang disalin dari tabel adalah panduan yang buruk. Ukurlah pada prompt Anda sendiri. Ini memakan satu menit dan menggunakan beberapa token (kuncinya berasal dari variabel lingkungan; lihat dokumentasi untuk membuatnya):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Anda mendapat satu baris: first text after <N>s, finished after <M>s. Ganti id model dengan zai- atau MiniMaxAI/, jalankan masing-masing beberapa kali, dan Anda punya perbandingan kecepatan untuk prompt Anda. Apakah itu penting? Untuk chat langsung, ya: orang menyadari jeda sebelum kata pertama. Untuk batch ringkasan semalam, tidak ada yang menonton, dan kecepatan turun ke dasar daftar Anda.
Harga: jumlahkan input dan output#
Harga dikutip per juta token, tetapi Anda membayar per permintaan, dan sebuah permintaan memiliki sisi input dan sisi output. Jadi bandingkan model pada beban kerja, bukan pada dua kolom. Misalkan bot dukungan Anda menangani 1.000 tiket sehari, masing-masing sekitar 300 token masuk dan 150 keluar (asumsi; ganti dengan angka Anda sendiri). Tabelnya langsung dan menghitung ulang dari harga saat ini:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 token input dan 150 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Baca totalnya, bukan kolomnya. Secara total, dengan input dan output dihitung bersama, ketiganya menjadi lebih murah daripada harga referensi OpenRouter di kolom OpenRouter tabel tersebut.
Dan di sinilah agen menggigit. Proses 20 langkah dari bagian context mengirim 420.000 token masuk dan menulis mungkin 4.000 keluar (200 per langkah, sekali lagi asumsi). Pada DeepSeek-V4-Flash satu proses seperti itu berbiaya $0.0067. Lima proses dalam sehari? Geser slider dan perhatikan ketiga model:
Kalkulator biaya
Sehari kerja agen: lima tugas 20 langkah
Token input per permintaan: 21.000 · Token output per permintaan: 200 · Permintaan per hari: 100
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Harga model tetap sama pada jam berapa pun, jadi perhitungan yang Anda lakukan sekarang juga berlaku untuk batch malam. Untuk penyegaran tentang mengapa token output biasanya lebih mahal daripada input, lihat token input dan output.
Pilih model berdasarkan tugas#
Mulailah dari tugasnya, temukan angka yang paling menggigit, lalu periksa tiga lainnya setelahnya. Klik melalui kasus Anda sendiri:
Pilih kasus Anda
Model mana untuk tugas saya?
Pilih opsi untuk melihat jawabannya
Bot dukungan dengan jawaban singkat
Pertanyaan dan jawaban singkat, jadi setiap model di katalog punya ruang berlebih, dan kolom harga yang menentukan. Jalankan tiket tipikal Anda melalui tabel biaya di atas dan mulai dengan GLM-5.3-Flash atau MiniMax-M2.7, mana pun yang totalnya terlihat lebih baik untuk angka Anda.
Asisten coding yang membaca banyak file
Context didahulukan. GLM-5.3-Flash memiliki window terbesar dari ketiganya yaitu 390K, DeepSeek-V4-Flash memiliki 380K. MiniMax-M2.7 dengan 180K cukup ketika file yang Anda kirim bersamaan tetap jauh di bawah itu.
Agen yang berulang melalui banyak langkah
Riwayat dikirim ulang di setiap langkah, jadi totalnya tumbuh cepat. DeepSeek-V4-Flash menggabungkan context 380K dengan hingga 32.768 token output per jawaban dan satu harga pada jam berapa pun, yang menjaga loop panjang tetap dapat diprediksi. Periksa totalnya dengan kalkulator di atas.
Laporan panjang dan kode yang dihasilkan
Max output yang menentukan. DeepSeek-V4-Flash menulis hingga 32.768 token per jawaban; GLM-5.3-Flash dan MiniMax-M2.7 menulis hingga 8.192, yang mencakup laporan sekitar 6.000 kata.
Tidak ada satu model yang menang di setiap baris, itulah sebabnya ada gunanya menjalankan sepuluh prompt nyata yang sama melalui dua kandidat sebelum Anda memutuskan. Perbandingan GLM vs DeepSeek vs MiniMax membahas ketiga model lebih dalam, dan halaman harga selalu menampilkan angka terkini.


