نئے سیکھنے والوں کے لیے AIگائیڈ
AI ماڈل کیسے چنیں: کانٹیکسٹ، آؤٹ پٹ، رفتار، قیمت
چیٹ، کوڈنگ یا ایجنٹ کے لیے چار نمبروں سے ماڈل چنیں: کانٹیکسٹ ونڈو، زیادہ سے زیادہ آؤٹ پٹ، رفتار اور قیمت۔ حل شدہ مثالیں اور لائیو لاگت جدول۔
اس صفحہ پر
چالیس ناموں کی ماڈل فہرست، ایک جملے میں بیان کردہ کام، اور دونوں کے درمیان کوئی واضح تعلق نہیں۔ مختصر جواب یہ ہے: چار نمبر چیک کریں، اسی ترتیب سے۔ کانٹیکسٹ ونڈو اور زیادہ سے زیادہ آؤٹ پٹ فیصلہ کرتے ہیں کہ ماڈل آپ کا کام کر سکتا ہے یا نہیں۔ رفتار اور قیمت فیصلہ کرتے ہیں کہ یہ کتنا خوشگوار اور کتنا مہنگا ہے۔ کانٹیکسٹ، آؤٹ پٹ کی حد اور قیمت ماڈلز کے صفحے اور قیمتوں کے جدول میں درج ہیں؛ رفتار آپ خود تقریباً ایک منٹ میں چیک کرتے ہیں، اور اسکرپٹ نیچے ہے۔
چار نمبر سادہ الفاظ میں#
ماڈل کو ڈیسک پر بیٹھے ساتھی کی طرح سمجھیں۔ کانٹیکسٹ ونڈو ڈیسک کا سائز ہے: وہ سب کچھ جو ایک وقت میں ان کے سامنے ہونا ضروری ہے۔ زیادہ سے زیادہ آؤٹ پٹ یہ ہے کہ وہ ایک بار میں کتنی دیر بول سکتے ہیں۔ رفتار یہ ہے کہ وہ کتنی جلدی جواب دینا شروع کرتے ہیں۔ قیمت ان کی فی گھنٹہ اجرت ہے۔ چار اصطلاحات، اور آپ ان سب سے ہر API دستاویز میں ملیں گے:
فلیش کارڈز
وہ الفاظ جو آپ ہر ماڈل فہرست میں دیکھیں گے
پلٹنے کے لیے کارڈ پر ٹیپ کریں
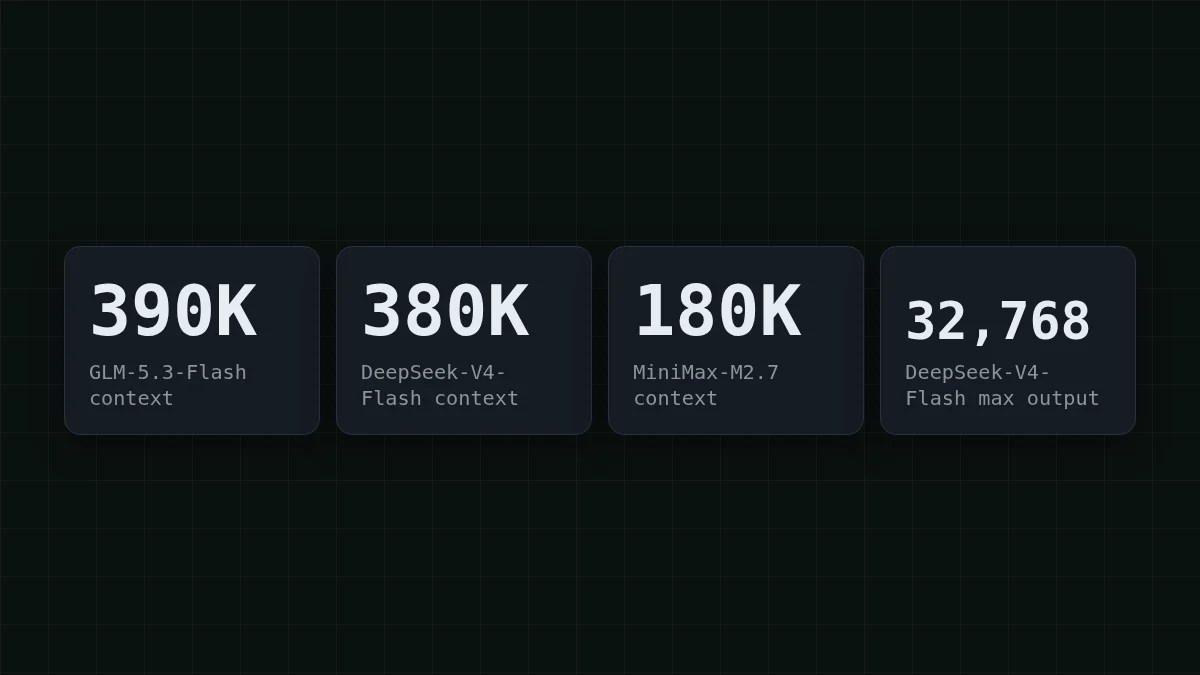
اسے ٹھوس بنانے کے لیے، CheapTokens کیٹلاگ میں تین ماڈلز کے پہلے دو نمبر یہ ہیں، CheapTokens ماڈل حوالہ (27 اکتوبر 2026) سے: GLM-5.3-Flash میں 390K کانٹیکسٹ ہے اور 8,192 ٹوکن تک جواب دیتا ہے؛ DeepSeek-V4-Flash (ریلیز 0731) میں 380K ہے اور 32,768 ٹوکن تک جواب دیتا ہے؛ MiniMax-M2.7 میں 180K ہے اور 8,192 ٹوکن تک جواب دیتا ہے۔
کانٹیکسٹ: کیا آپ کا بھیجا ہوا سب کچھ فٹ ہوگا؟#
فرض کریں آپ کا کوڈنگ اسسٹنٹ تقریباً 3,000 ٹوکن کی 12 فائلیں کھولتا ہے، پھر آپ کا سوال اور اپنے نوٹس شامل کرتا ہے۔ 12 × 3,000 = 36,000 ٹوکن۔ اوپر کی سب سے چھوٹی ونڈو، 180K، بھی اسے کافی جگہ کے ساتھ رکھ لیتی ہے۔ ایک بہت بڑی فائل یا پورے ریپوزٹری کا ڈمپ وہ جگہ ہے جہاں ونڈو اہم ہونے لگتی ہے۔
چیٹس اور ایجنٹس زیادہ پیچیدہ ہیں، کیونکہ API ہر کال کے ساتھ پوری ہسٹری دوبارہ بھیجتا ہے۔ ایک ایجنٹ لیں جو 20 مراحل چلتا ہے، اور ہر مرحلہ تقریباً 2,000 ٹوکن ٹول آؤٹ پٹ اور جواب شامل کرتا ہے (اس مثال کے لیے ایک مفروضہ)۔ مرحلہ 1 میں 2,000 ٹوکن بھیجے جاتے ہیں، مرحلہ 2 میں 4,000، مرحلہ 20 میں 40,000۔ پوری رن میں یہ 2,000 × 210 = 420,000 ٹوکن بھیجتا ہے، جہاں 210 = 1 + 2 + … + 20۔
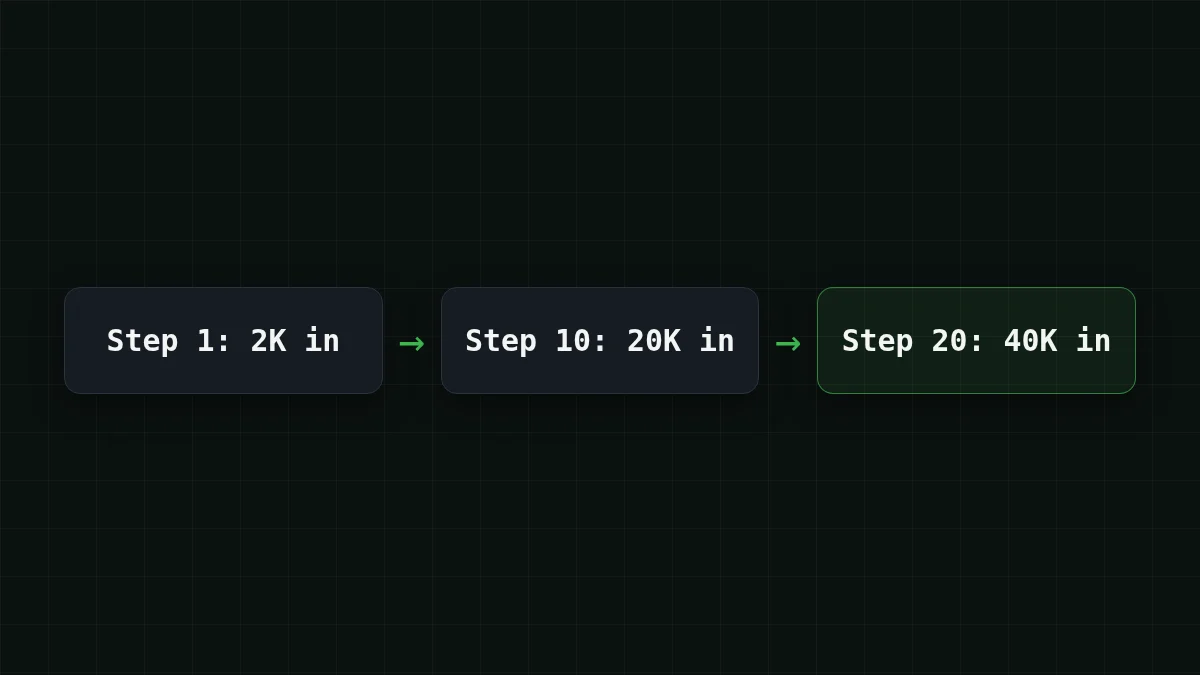
یہاں دو مختلف سوالات چھپے ہیں۔ کانٹیکسٹ ونڈو صرف سب سے بڑی واحد درخواست کی پرواہ کرتی ہے: مرحلہ 20 پر 40,000 ٹوکن، جو کیٹلاگ کا ہر ماڈل آسانی سے رکھ لیتا ہے۔ بل کل کی پرواہ کرتا ہے، 420,000 ٹوکن۔ دونوں کو ذہن میں رکھیں، اور آپ غلط وجہ سے ماڈل نہیں چنیں گے۔
آؤٹ پٹ کی لمبائی: وہ حد جو جوابات کو کاٹ دیتی ہے#
آؤٹ پٹ کی حد ایک جواب پر چھت ہے، اور اسے بھولنا آسان ہے جب تک جواب درمیان میں رک نہ جائے۔ انگریزی کے لیے ایک اصول: ایک ٹوکن تقریباً ایک لفظ کا تین چوتھائی ہے۔ آپ 6000 الفاظ کی رپورٹ مانگتے ہیں: 6000 / 0.75 = 8000 ٹوکن۔ یہ 8,192 کے بالکل نیچے فٹ ہوتا ہے۔ 7,000 الفاظ مانگیں اور متن پیراگراف کے درمیان ختم ہو جاتا ہے۔
32,768 ٹوکن کی چھت کے ساتھ وہی حساب ایک جواب میں 24576 الفاظ بنتا ہے (32768 × 0.75 = 24576)، لہٰذا جنریٹڈ کوڈ، لمبی رپورٹس اور پورے ابواب کے مسودے ایک ہی جواب میں فٹ ہو جاتے ہیں۔ جب جواب واقعی کٹ جائے، تو API آپ کو بتاتا ہے: finish_reason length کے طور پر واپس آتا ہے (ایسا کیوں ہوتا ہے اور اسے کیسے ٹھیک کریں)۔
فوری جانچ
آپ 8,192 ٹوکن آؤٹ پٹ کی حد والے ماڈل سے 12,000 الفاظ کی رپورٹ مانگتے ہیں۔ آپ کو کیا ملتا ہے؟
جواب دکھائیں
جواب: ایک رپورٹ جو درمیان میں رک جاتی ہے، finish_reason length پر سیٹ ہوتا ہے
12,000 الفاظ تقریباً 16,000 ٹوکن ہیں، جو حد سے دوگنا ہے۔ ماڈل لکھتا ہے جب تک چھت تک نہ پہنچے اور رک جاتا ہے، اور API جواب کو finish_ سے نشان زد کرتا ہے۔
رفتار: وہ واحد نمبر جو آپ خود ناپتے ہیں#
رفتار دراصل دو نمبر ہیں: پہلا متن ظاہر ہونے میں کتنا وقت لگتا ہے، اور باقی کتنی تیزی سے آتا ہے۔ دونوں لوڈ، پرامپٹ کی لمبائی اور دن کے وقت کے ساتھ بدلتے ہیں، اس لیے جدول سے کاپی کیا گیا عدد ناقص رہنما ہے۔ اسے اپنے پرامپٹ پر ناپیں۔ اس میں ایک منٹ لگتا ہے اور چند ٹوکن استعمال ہوتے ہیں (کلید ماحول کے متغیر سے آتی ہے؛ بنانے کے لیے دستاویزات دیکھیں):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
آپ کو ایک لائن ملتی ہے: first text after <N>s, finished after <M>s۔ ماڈل آئی ڈی کو zai- یا MiniMaxAI/ سے بدلیں، ہر ایک کو چند بار چلائیں، اور آپ کے پرامپٹ کے لیے رفتار کا موازنہ تیار ہے۔ کیا یہ اہم ہے؟ لائیو چیٹ کے لیے، ہاں: لوگ پہلے لفظ سے پہلے وقفہ محسوس کرتے ہیں۔ رات کے بیچ خلاصوں کے لیے، کوئی نہیں دیکھ رہا، اور رفتار آپ کی فہرست کے نیچے چلی جاتی ہے۔
قیمت: ان پٹ اور آؤٹ پٹ کو ملا کر جمع کریں#
قیمتیں فی ملین ٹوکن بتائی جاتی ہیں، لیکن آپ فی درخواست ادا کرتے ہیں، اور ایک درخواست کا ان پٹ پہلو اور آؤٹ پٹ پہلو دونوں ہوتے ہیں۔ لہٰذا ماڈلز کا موازنہ کسی ورک لوڈ پر کریں، دو کالموں پر نہیں۔ فرض کریں آپ کا سپورٹ بوٹ روزانہ 1,000 ٹکٹ سنبھالتا ہے، ہر ایک تقریباً 300 ٹوکن ان اور 150 آؤٹ (ایک مفروضہ؛ اسے اپنے نمبروں سے بدلیں)۔ جدول لائیو ہے اور موجودہ قیمتوں سے دوبارہ حساب کرتا ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
فی درخواست 300 ان پٹ اور 150 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
کل پڑھیں، کالم نہیں۔ کل میں، ان پٹ اور آؤٹ پٹ کو ملا کر، تینوں میں سے ہر ایک اس جدول کے OpenRouter کالم میں OpenRouter کی حوالہ قیمت سے سستا نکلتا ہے۔
اور یہاں ایجنٹس کاٹتے ہیں۔ کانٹیکسٹ سیکشن کی 20 مرحلوں والی رن 420,000 ٹوکن ان بھیجتی ہے اور شاید 4,000 آؤٹ لکھتی ہے (فی مرحلہ 200، پھر ایک مفروضہ)۔ DeepSeek-V4-Flash پر ایسی ایک رن کی لاگت $0.0067 ہے۔ ایک دن میں پانچ رنیں؟ سلائیڈرز ہلائیں اور تینوں ماڈلز دیکھیں:
لاگت کیلکولیٹر
ایجنٹ کام کا ایک دن: پانچ 20 مرحلوں والے کام
فی درخواست ان پٹ ٹوکنز: 21,000 · فی درخواست آؤٹ پٹ ٹوکنز: 200 · فی دن درخواستیں: 100
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
ماڈل کی قیمتیں دن کے کسی بھی وقت وہی رہتی ہیں، اس لیے اب کیا گیا حساب شام کے بیچ کے لیے بھی درست رہتا ہے۔ آؤٹ پٹ ٹوکن عام طور پر ان پٹ سے زیادہ مہنگے کیوں ہوتے ہیں، اس کی تازہ کاری کے لیے ان پٹ اور آؤٹ پٹ ٹوکن دیکھیں۔
کام کے مطابق ماڈل چنیں#
کام سے شروع کریں، وہ نمبر تلاش کریں جو سب سے زیادہ کاٹتا ہے، اور بعد میں باقی تین چیک کریں۔ اپنے کیس پر کلک کریں:
اپنا کیس منتخب کریں
میرے کام کے لیے کون سا ماڈل؟
جواب دیکھنے کے لیے ایک آپشن منتخب کریں
مختصر جوابات والا سپورٹ بوٹ
سوالات اور جوابات مختصر ہیں، اس لیے کیٹلاگ کے ہر ماڈل میں کافی جگہ ہے، اور قیمت کا کالم فیصلہ کرتا ہے۔ اپنے عام ٹکٹ کو اوپر کے لاگت جدول سے گزار کر دیکھیں اور GLM-5.3-Flash یا MiniMax-M2.7 سے شروع کریں، جو بھی آپ کے نمبروں کے لیے بہتر کل دکھائے۔
بہت سی فائلیں پڑھنے والا کوڈنگ اسسٹنٹ
کانٹیکسٹ پہلے آتا ہے۔ GLM-5.3-Flash میں تینوں میں سب سے بڑی ونڈو 390K ہے، DeepSeek-V4-Flash میں 380K ہے۔ MiniMax-M2.7 کا 180K کافی ہے جب آپ کی ایک ساتھ بھیجی گئی فائلیں اس سے کافی کم رہیں۔
بہت سے مراحل پر لوپ کرنے والا ایجنٹ
ہر مرحلے پر ہسٹری دوبارہ بھیجی جاتی ہے، اس لیے کل تیزی سے بڑھتا ہے۔ DeepSeek-V4-Flash 380K کانٹیکسٹ کو فی جواب 32,768 آؤٹ پٹ ٹوکن تک اور کسی بھی وقت ایک قیمت کے ساتھ جوڑتا ہے، جو لمبے لوپس کو قابل پیش گوئی رکھتا ہے۔ اوپر کیلکولیٹر سے کل چیک کریں۔
لمبی رپورٹس اور جنریٹڈ کوڈ
زیادہ سے زیادہ آؤٹ پٹ فیصلہ کرتا ہے۔ DeepSeek-V4-Flash فی جواب 32,768 ٹوکن تک لکھتا ہے؛ GLM-5.3-Flash اور MiniMax-M2.7 8,192 تک لکھتے ہیں، جو تقریباً 6,000 الفاظ کی رپورٹ کے لیے کافی ہے۔
کوئی اکیلا ماڈل ہر قطار نہیں جیتتا، اسی لیے فائدہ مند ہے کہ وعدہ کرنے سے پہلے وہی دس حقیقی پرامپٹ دو امیدواروں پر چلائیں۔ GLM بمقابلہ DeepSeek بمقابلہ MiniMax موازنہ تینوں ماڈلز پر گہرائی میں جاتا ہے، اور قیمتوں کا صفحہ ہمیشہ موجودہ نمبر دکھاتا ہے۔


