AI สำหรับผู้เริ่มต้นคู่มือ
วิธีเลือกโมเดล AI: บริบท เอาต์พุต ความเร็ว ราคา
เลือกโมเดลสำหรับแชท เขียนโค้ด หรือเอเจนต์ด้วยตัวเลขสี่ตัว: หน้าต่างบริบท เอาต์พุตสูงสุด ความเร็ว และราคา ตัวอย่างที่คำนวณให้และตารางค่าใช้จ่ายสด
ในหน้านี้
รายชื่อโมเดลสี่สิบชื่อ งานที่อธิบายในหนึ่งประโยค และไม่มีความเชื่อมโยงที่ชัดเจนระหว่างสองสิ่งนี้ นี่คือคำตอบสั้น ๆ: ตรวจสอบตัวเลขสี่ตัว ตามลำดับนี้ หน้าต่างบริบท และ เอาต์พุตสูงสุด ตัดสินว่าโมเดลจะทำงานของคุณได้หรือไม่ ความเร็ว และ ราคา ตัดสินว่ามันน่าพอใจแค่ไหนและแพงแค่ไหน บริบท ขีดจำกัดเอาต์พุต และราคาแสดงอยู่ในหน้ารายการโมเดล และในตารางราคา ส่วนความเร็วคุณวัดเองได้ในเวลาประมาณหนึ่งนาที และสคริปต์อยู่ด้านล่าง
ตัวเลขสี่ตัวในคำง่าย ๆ#
ลองคิดว่าโมเดลเป็นเพื่อนร่วมงานที่นั่งอยู่ที่โต๊ะ หน้าต่างบริบทคือขนาดของโต๊ะ: ทุกอย่างที่ต้องอยู่ตรงหน้าพวกเขาพร้อมกัน เอาต์พุตสูงสุดคือความยาวที่พวกเขาพูดได้ในครั้งเดียว ความเร็วคือความเร็วที่พวกเขาเริ่มตอบ ราคาคืออัตราค่าจ้างรายชั่วโมง สี่คำ และคุณจะพบทั้งหมดนี้ในเอกสาร API ทุกฉบับ:
แฟลชการ์ด
คำที่คุณจะพบในรายการโมเดลทุกแห่ง
แตะการ์ดเพื่อพลิก
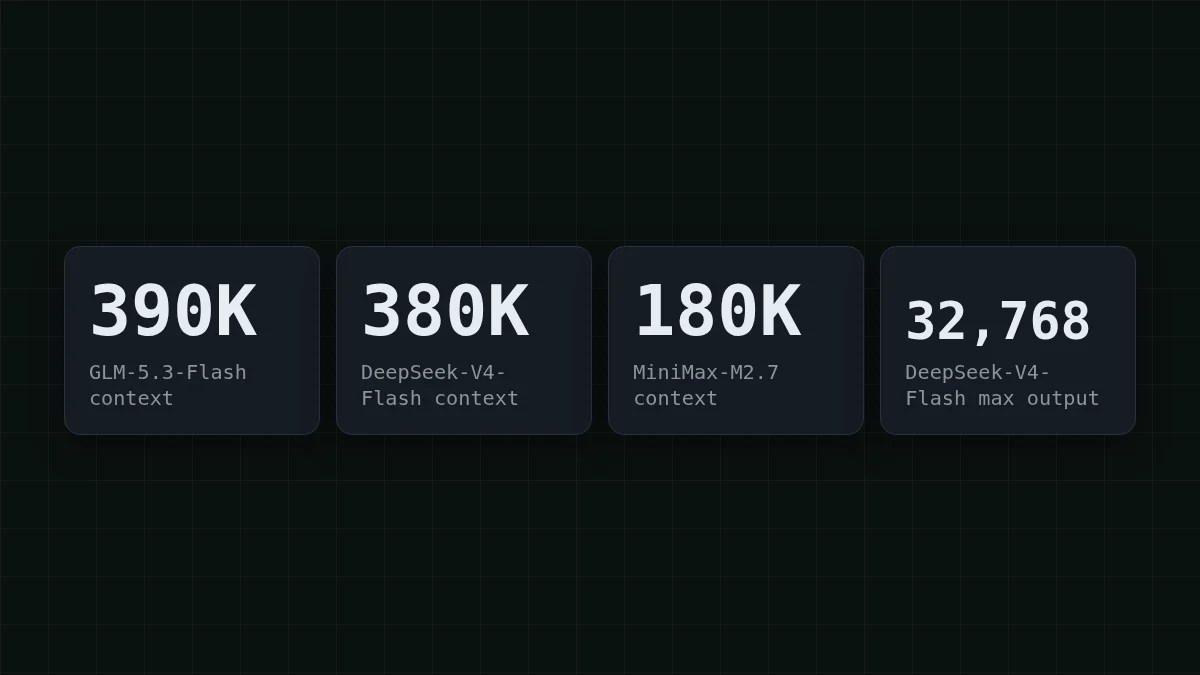
เพื่อให้เห็นภาพชัดเจน นี่คือตัวเลขสองตัวแรกของสามโมเดลในแคตตาล็อก CheapTokens จากเอกสารอ้างอิงโมเดล CheapTokens (27 ตุลาคม 2026): GLM-5.3-Flash มีบริบท 390K และตอบได้สูงสุด 8,192 โทเค็น; DeepSeek-V4-Flash (รุ่น 0731) มี 380K และตอบได้สูงสุด 32,768 โทเค็น; MiniMax-M2.7 มี 180K และตอบได้สูงสุด 8,192 โทเค็น
บริบท: ทุกอย่างที่คุณส่งจะพอดีหรือไม่?#
สมมติว่าผู้ช่วยเขียนโค้ดของคุณเปิด 12 ไฟล์ ไฟล์ละประมาณ 3,000 โทเค็น แล้วเพิ่มคำถามของคุณและบันทึกของมันเอง 12 × 3,000 = 36,000 โทเค็น แม้แต่หน้าต่างที่เล็กที่สุดข้างต้น 180K ก็เก็บได้สบาย ๆ ไฟล์ขนาดใหญ่ไฟล์เดียวหรือการดัมป์ทั้งรีโพซิทอรีคือจุดที่หน้าต่างเริ่มมีความสำคัญ
แชทและเอเจนต์ยุ่งยากกว่า เพราะ API ส่งประวัติทั้งหมดซ้ำ ทุกครั้งที่เรียก ใช้เอเจนต์ที่ทำงาน 20 ขั้นตอน และแต่ละขั้นตอนเพิ่มเอาต์พุตเครื่องมือและคำตอบประมาณ 2,000 โทเค็น (สมมติฐานสำหรับตัวอย่างนี้) ขั้นตอนที่ 1 ส่ง 2,000 โทเค็น ขั้นตอนที่ 2 ส่ง 4,000 ขั้นตอนที่ 20 ส่ง 40,000 ตลอดการทำงานทั้งหมดส่ง 2,000 × 210 = 420,000 โทเค็น โดย 210 คือ 1 + 2 + … + 20
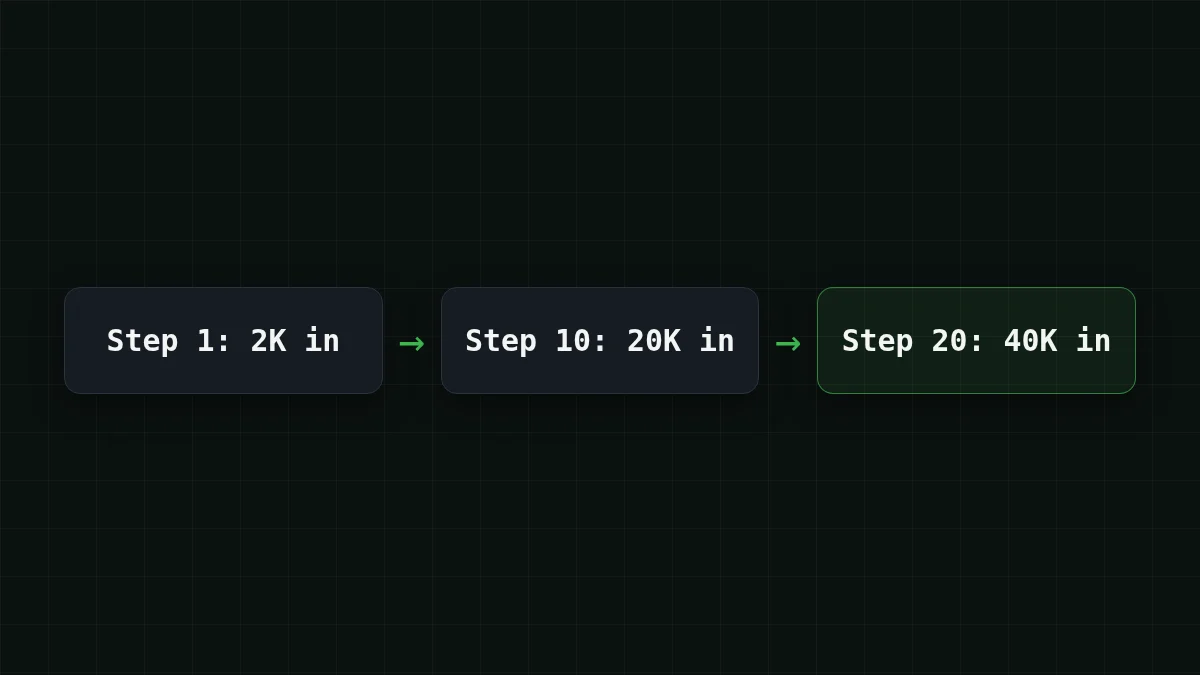
มีคำถามสองข้อที่แตกต่างกันซ่อนอยู่ตรงนี้ หน้าต่างบริบท สนใจเฉพาะคำขอเดียวที่ใหญ่ที่สุด: 40,000 โทเค็นที่ขั้นตอนที่ 20 ซึ่งโมเดลทุกตัวในแคตตาล็อกเก็บได้ง่าย ๆ บิล สนใจยอดรวม 420,000 โทเค็น เก็บทั้งสองไว้ในหัว แล้วคุณจะไม่เลือกโมเดลด้วยเหตุผลผิด ๆ
ความยาวเอาต์พุต: ขีดจำกัดที่ตัดคำตอบให้สั้นลง#
ขีดจำกัดเอาต์พุตคือเพดานของการตอบกลับหนึ่งครั้ง และเป็นเรื่องง่ายที่จะลืมจนกว่าคำตอบจะหยุดกลางประโยค กฎง่าย ๆ สำหรับภาษาอังกฤษ: หนึ่งโทเค็นประมาณสามในสี่ของคำ คุณขอรายงาน 6000 คำ: 6000 / 0.75 = 8000 โทเค็น ซึ่งพอดีใต้ 8,192 ขอ 7,000 คำ แล้วข้อความจะจบกลางย่อหน้า
ด้วยเพดาน 32,768 โทเค็น การคำนวณเดียวกันได้ 24576 คำในคำตอบเดียว (32768 × 0.75 = 24576) ดังนั้นโค้ดที่สร้างขึ้น รายงานยาว และร่างทั้งบทจึงพอดีในการตอบกลับครั้งเดียว เมื่อคำตอบถูกตัดจริง API จะบอกคุณ: finish_reason กลับมาเป็น length (ทำไมจึงเกิดขึ้นและแก้อย่างไร)
เช็กด่วน
คุณขอรายงาน 12,000 คำจากโมเดลที่มีขีดจำกัดเอาต์พุต 8,192 โทเค็น คุณจะได้อะไร?
แสดงคำตอบ
คำตอบ: รายงานที่หยุดกลางทาง โดย finish_reason ตั้งเป็น length
12,000 คำประมาณ 16,000 โทเค็น เป็นสองเท่าของเพดาน โมเดลเขียนจนชนเพดานแล้วหยุด และ API ทำเครื่องหมายคำตอบด้วย finish_
ความเร็ว: ตัวเลขเดียวที่คุณวัดเอง#
ความเร็วจริง ๆ คือสองตัวเลข: ใช้เวลานานแค่ไหนกว่าข้อความแรกจะปรากฏ และส่วนที่เหลือสตรีมเข้ามาเร็วแค่ไหน ทั้งสองเปลี่ยนตามโหลด ความยาวพรอมป์ต์ และเวลาของวัน ดังนั้นตัวเลขที่คัดลอกจากตารางจึงเป็นแนวทางที่ไม่ดี วัดกับพรอมป์ต์ของคุณเอง ใช้เวลาหนึ่งนาทีและใช้โทเค็นไม่กี่ตัว (คีย์มาจากตัวแปรสภาพแวดล้อม ดูเอกสารสำหรับการสร้างคีย์):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
คุณจะได้หนึ่งบรรทัด: first text after <N>s, finished after <M>s สลับ model id เป็น zai- หรือ MiniMaxAI/ รันแต่ละตัวสองสามครั้ง แล้วคุณจะมีการเปรียบเทียบความเร็วสำหรับพรอมป์ต์ของคุณ มันสำคัญไหม? สำหรับแชทสด ใช่: ผู้คนสังเกตเห็นการหยุดก่อนคำแรก สำหรับชุดสรุปรายคืน ไม่มีใครดู และความเร็วก็ตกลงไปล่างสุดของรายการ
ราคา: บวกอินพุตและเอาต์พุตรวมกัน#
ราคาถูกอ้างต่อล้านโทเค็น แต่คุณจ่ายต่อคำขอ และคำขอมีทั้งฝั่งอินพุตและฝั่งเอาต์พุต ดังนั้นเปรียบเทียบโมเดลบนปริมาณงาน ไม่ใช่บนสองคอลัมน์ สมมติว่าบอทสนับสนุนของคุณจัดการ 1,000 ตั๋วต่อวัน แต่ละตั๋วประมาณ 300 โทเค็นเข้าและ 150 ออก (สมมติฐาน; แทนที่ด้วยตัวเลขของคุณเอง) ตารางเป็นแบบสดและคำนวณใหม่จากราคาปัจจุบัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 โทเค็นอินพุตและ 150 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
อ่านยอดรวม ไม่ใช่คอลัมน์ โดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน แต่ละตัวในสามตัวถูกกว่าค่าราคาอ้างอิงของ OpenRouter ในคอลัมน์ OpenRouter ของตารางนั้น
และนี่คือจุดที่เอเจนต์กัด การทำงาน 20 ขั้นตอนจากส่วนบริบทส่ง 420,000 โทเค็นเข้าและเขียนออกมาประมาณ 4,000 (200 ต่อขั้นตอน อีกครั้งเป็นสมมติฐาน) บน DeepSeek-V4-Flash การทำงานหนึ่งครั้งมีค่าใช้จ่าย $0.0067 ห้าครั้งในหนึ่งวัน? เลื่อนแถบเลื่อนและดูสามโมเดล:
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของงานเอเจนต์: งาน 20 ขั้นตอนห้าครั้ง
โทเค็นอินพุตต่อคำขอ: 21,000 · โทเค็นเอาต์พุตต่อคำขอ: 200 · คำขอต่อวัน: 100
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
ราคาโมเดลคงเดิมทุกชั่วโมงของวัน ดังนั้นการคำนวณที่คุณทำตอนนี้ใช้ได้กับชุดตอนเย็นด้วย สำหรับทบทวนว่าทำไมโทเค็นเอาต์พุตมักแพงกว่าอินพุต ดูโทเค็นอินพุตและเอาต์พุต
เลือกโมเดลตามงาน#
เริ่มจากงาน หาตัวเลขที่กัดแรงที่สุด แล้วตรวจสอบอีกสามตัวหลังจากนั้น คลิกผ่านกรณีของคุณเอง:
เลือกกรณีของคุณ
โมเดลไหนสำหรับงานของฉัน?
เลือกตัวเลือกเพื่อดูคำตอบ
บอทสนับสนุนที่มีคำตอบสั้น
คำถามและคำตอบสั้น ดังนั้นโมเดลทุกตัวในแคตตาล็อกมีที่เหลือเฟือ และคอลัมน์ราคาตัดสิน รันตั๋วทั่วไปของคุณผ่านตารางค่าใช้จ่ายด้านบนและเริ่มด้วย GLM-5.3-Flash หรือ MiniMax-M2.7 แล้วแต่ยอดรวมใดดูดีกว่าสำหรับตัวเลขของคุณ
ผู้ช่วยเขียนโค้ดที่อ่านหลายไฟล์
บริบทมาก่อน GLM-5.3-Flash มีหน้าต่างใหญ่ที่สุดในสามตัวที่ 390K, DeepSeek-V4-Flash มี 380K MiniMax-M2.7 ที่ 180K เพียงพอเมื่อไฟล์ที่คุณส่งพร้อมกันอยู่ต่ำกว่านั้นมาก
เอเจนต์ที่วนซ้ำหลายขั้นตอน
ประวัติถูกส่งซ้ำทุกขั้นตอน ดังนั้นยอดรวมจึงโตเร็ว DeepSeek-V4-Flash รวมบริบท 380K กับเอาต์พุตสูงสุด 32,768 โทเค็นต่อคำตอบและราคาเดียวทุกชั่วโมง ซึ่งทำให้ลูปยาวคาดเดาได้ ตรวจสอบยอดรวมด้วยเครื่องคิดเลขด้านบน
รายงานยาวและโค้ดที่สร้างขึ้น
เอาต์พุตสูงสุดตัดสิน DeepSeek-V4-Flash เขียนได้สูงสุด 32,768 โทเค็นต่อคำตอบ; GLM-5.3-Flash และ MiniMax-M2.7 เขียนได้สูงสุด 8,192 ซึ่งครอบคลุมรายงานประมาณ 6,000 คำ
ไม่มีโมเดลเดียวที่ชนะทุกแถว ซึ่งเป็นเหตุผลว่าทำไมจึงช่วยให้รันพรอมป์ต์จริงสิบตัวเดียวกันผ่านสองตัวเลือกก่อนตัดสินใจ การเปรียบเทียบ GLM vs DeepSeek vs MiniMax เจาะลึกสามโมเดลนี้ และหน้าราคาแสดงตัวเลขปัจจุบันเสมอ


