AI для початківцівПосібник
Як вибрати модель ШІ: контекст, вивід, швидкість, ціна
Виберіть модель для чату, кодування чи агента за чотирма числами: контекстне вікно, максимальний вивід, швидкість і ціна. Приклади з розрахунками та жива таблиця витрат.
На цій сторінці
Список моделей із сорока назвами, завдання, описане одним реченням, і жодного очевидного зв'язку між ними. Ось коротка відповідь: перевірте чотири числа, саме в такому порядку. Контекстне вікно та максимальний вивід вирішують, чи взагалі модель може виконати ваше завдання. Швидкість і ціна вирішують, наскільки це приємно і наскільки дорого. Контекст, ліміт виводу та ціна вказані на сторінці моделей і в таблиці цін; швидкість вимірюєте самі приблизно за хвилину, а скрипт наведено нижче.
Чотири числа простими словами#
Уявіть модель як колегу за столом. Контекстне вікно — це розмір столу: усе, що має бути перед ним одночасно. Максимальний вивід — це як довго він може говорити за один раз. Швидкість — це як швидко він починає відповідати. Ціна — це його погодинна ставка. Чотири терміни, і ви зустрінете їх усі в кожній документації API:
Флеш-картки
Слова, які ви зустрінете в кожному списку моделей
Торкніться картки, щоб перевернути її
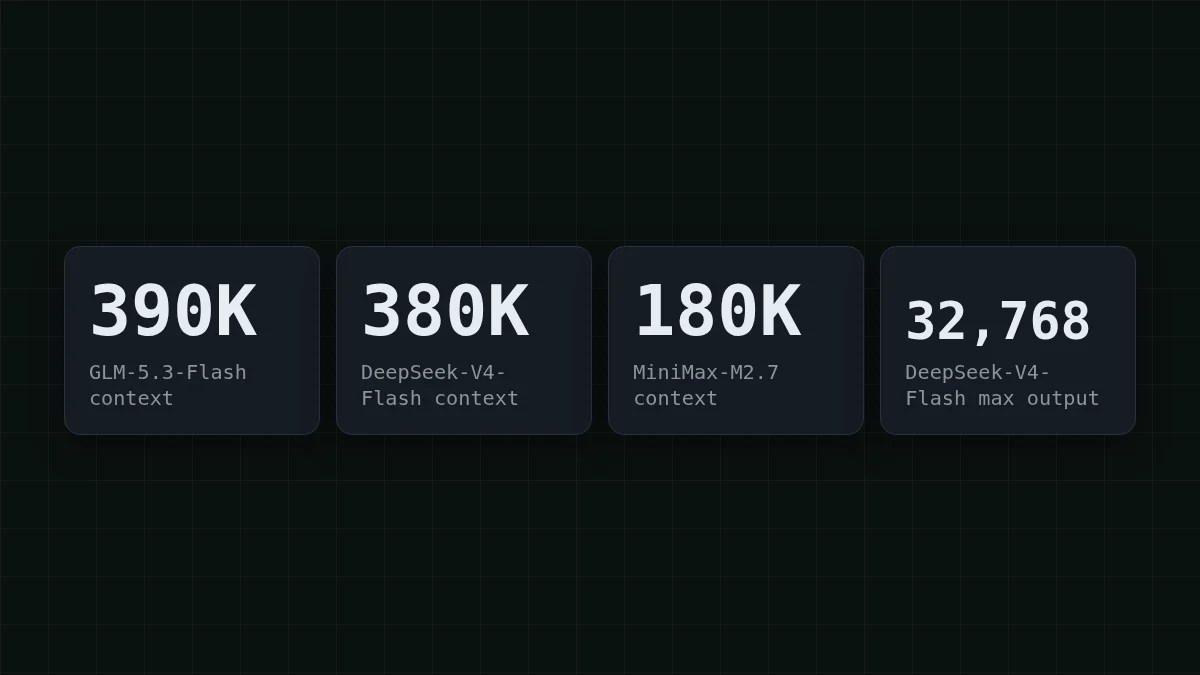
Щоб це було конкретніше, ось перші два числа для трьох моделей у каталозі CheapTokens, з довідника моделей CheapTokens (27 жовтня 2026): GLM-5.3-Flash має контекст 390K і відповідає до 8,192 токенів; DeepSeek-V4-Flash (випуск 0731) має 380K і відповідає до 32,768 токенів; MiniMax-M2.7 має 180K і відповідає до 8,192 токенів.
Контекст: чи вміститься все, що ви надсилаєте?#
Скажімо, ваш асистент для кодування відкриває 12 файлів приблизно по 3,000 токенів кожен, потім додає ваше запитання та власні нотатки. 12 × 3,000 = 36,000 токенів. Навіть найменше вікно вище, 180K, вміщує це з великим запасом. Один величезний файл або дамп усього репозиторію — ось де вікно починає мати значення.
Чати та агенти складніші, бо API надсилає всю історію заново з кожним викликом. Візьміть агента, який виконує 20 кроків, і кожен крок додає близько 2,000 токенів виводу інструментів і відповіді (припущення для цього прикладу). Крок 1 надсилає 2,000 токенів, крок 2 надсилає 4,000, крок 20 надсилає 40,000. За весь запуск він надсилає 2,000 × 210 = 420,000 токенів, де 210 — це 1 + 2 + … + 20.
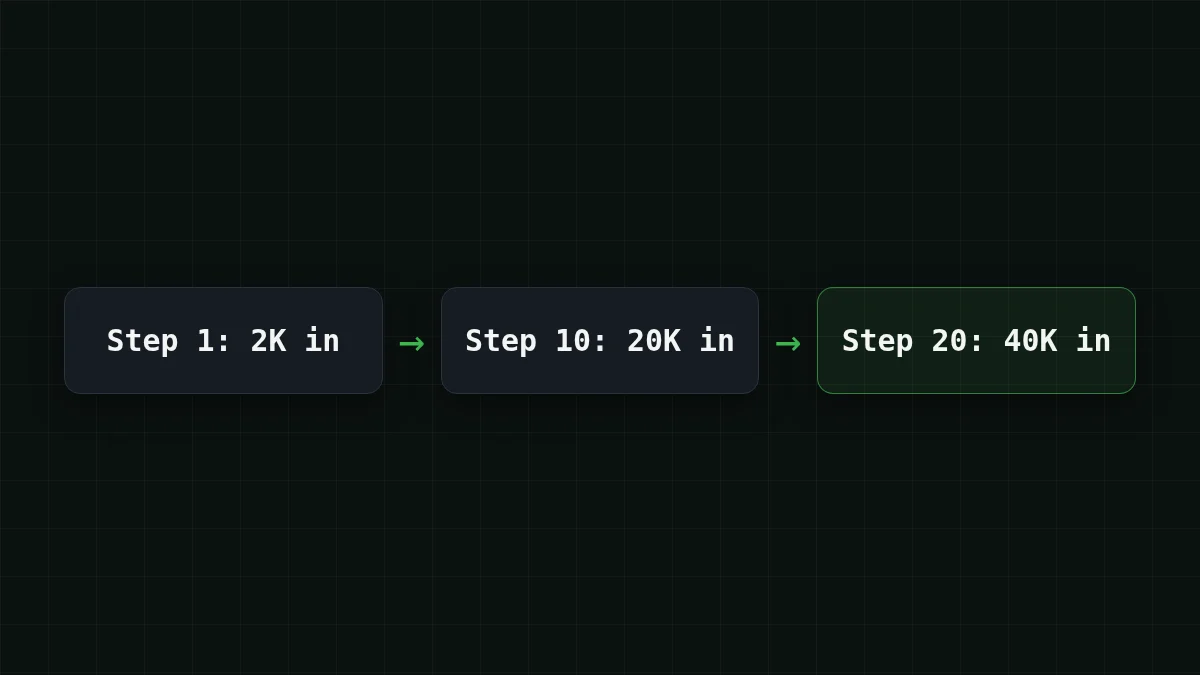
Тут ховаються два різні питання. Контекстне вікно стосується лише найбільшого окремого запиту: 40,000 токенів на кроці 20, що легко вміщує кожна модель у каталозі. Рахунок стосується загальної суми, 420,000 токенів. Тримайте обидва в голові, і ви не виберете модель з неправильної причини.
Довжина виводу: ліміт, який обриває відповіді#
Ліміт виводу — це стеля для однієї відповіді, і про нього легко забути, поки відповідь не зупиниться посеред речення. Емпіричне правило для англійської: один токен — це приблизно три чверті слова. Ви просите звіт на 6000 слів: 6000 / 0.75 = 8000 токенів. Це якраз вміщується під 8,192. Попросіть 7,000 слів — і текст закінчиться посеред абзацу.
З лімітом 32,768 токенів та сама арифметика дає 24576 слів в одній відповіді (32768 × 0.75 = 24576), тож згенерований код, довгі звіти та чернетки цілих розділів вміщуються в одну відповідь. Коли відповідь таки обривається, API повідомляє вам: finish_reason повертається як length (чому це відбувається і як це виправити).
Швидка перевірка
Ви просите модель з лімітом виводу 8,192 токени для звіту на 12,000 слів. Що ви отримаєте?
Показати відповідь
Відповідь: Звіт, який зупиняється на півдорозі, з finish_reason встановленим у length
12,000 слів — це близько 16,000 токенів, удвічі більше за ліміт. Модель пише, поки не досягне стелі, і зупиняється, а API позначає відповідь як finish_.
Швидкість: єдине число, яке ви вимірюєте самі#
Швидкість — це насправді два числа: скільки часу до появи першого тексту і як швидко решта надходить потоком. Обидва змінюються залежно від навантаження, довжини запиту та часу доби, тож цифра, скопійована з таблиці, — поганий орієнтир. Вимірюйте на власному запиті. Це займає хвилину і використовує кілька токенів (ключ береться зі змінної середовища; дивіться документацію щодо його створення):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Ви отримаєте один рядок: first text after <N>s, finished after <M>s. Замініть ідентифікатор моделі на zai- або MiniMaxAI/, запустіть кожен кілька разів — і у вас є порівняння швидкості для вашого запиту. Чи це важливо? Для живого чату — так: люди помічають паузу перед першим словом. Для нічного пакета підсумків ніхто не спостерігає, і швидкість опускається в кінець вашого списку.
Ціна: додайте вхід і вихід разом#
Ціни вказуються за мільйон токенів, але ви платите за запит, а запит має і вхідну, і вихідну частину. Тож порівнюйте моделі на робочому навантаженні, а не за двома стовпцями. Скажімо, ваш бот підтримки обробляє 1,000 тікетів на день, кожен близько 300 токенів на вході та 150 на виході (припущення; замініть своїми). Таблиця жива і перераховується з поточних цін:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 вхідних і 150 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Читайте підсумок, а не стовпці. У підсумку, з урахуванням входу і виходу разом, кожна з трьох виходить дешевше за довідкову ціну OpenRouter у стовпці OpenRouter цієї таблиці.
І ось де агенти кусаються. 20-кроковий запуск із розділу про контекст надсилає 420,000 токенів на вході та пише, можливо, 4,000 на виході (200 на крок, знову припущення). На DeepSeek-V4-Flash один такий запуск коштує $0.0067. П'ять запусків на день? Рухайте повзунки й дивіться на три моделі:
Калькулятор вартості
День роботи агента: п'ять 20-крокових завдань
Вхідні токени на запит: 21 000 · Вихідні токени на запит: 200 · Запитів на день: 100
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Ціни моделей залишаються однаковими в будь-яку годину доби, тож розрахунок, зроблений зараз, дійсний і для вечірнього пакета. Щоб освіжити в пам'яті, чому вихідні токени зазвичай коштують дорожче за вхідні, дивіться вхідні та вихідні токени.
Виберіть модель за завданням#
Почніть із завдання, знайдіть число, яке кусається найсильніше, і перевірте решту три після цього. Клікніть свій випадок:
Оберіть свій випадок
Яка модель для мого завдання?
Виберіть варіант, щоб побачити відповідь
Бот підтримки з короткими відповідями
Запитання та відповіді короткі, тож кожна модель у каталозі має запас, і стовпець ціни вирішує. Проженіть свій типовий тікет через таблицю витрат вище і почніть з GLM-5.3-Flash або MiniMax-M2.7 — залежно від того, який підсумок виглядає краще для ваших чисел.
Асистент для кодування, який читає багато файлів
Контекст на першому місці. GLM-5.3-Flash має найбільше вікно з трьох — 390K, DeepSeek-V4-Flash має 380K. MiniMax-M2.7 з 180K достатньо, коли файли, які ви надсилаєте разом, залишаються значно меншими за це.
Агент, який циклічно виконує багато кроків
Історія надсилається заново на кожному кроці, тож загальна сума швидко зростає. DeepSeek-V4-Flash поєднує контекст 380K з до 32,768 вихідних токенів на відповідь і однією ціною в будь-яку годину, що робить довгі цикли передбачуваними. Перевірте підсумок калькулятором вище.
Довгі звіти та згенерований код
Максимальний вивід вирішує. DeepSeek-V4-Flash пише до 32,768 токенів на відповідь; GLM-5.3-Flash і MiniMax-M2.7 пишуть до 8,192, що покриває звіт приблизно на 6,000 слів.
Жодна модель не виграє в кожному рядку, тому корисно прогнати ті самі десять реальних запитів через двох кандидатів, перш ніж зробити вибір. Порівняння GLM vs DeepSeek vs MiniMax заглиблюється в три моделі, а сторінка цін завжди показує поточні числа.


