AI cho người mớiHướng dẫn
Cách chọn một mô hình AI: ngữ cảnh, đầu ra, tốc độ, giá
Chọn một mô hình cho trò chuyện, lập trình hoặc agent với bốn con số: cửa sổ ngữ cảnh, đầu ra tối đa, tốc độ và giá. Ví dụ cụ thể và bảng chi phí trực tiếp.
Trên trang này
Một danh sách mô hình với bốn mươi cái tên, một nhiệm vụ được mô tả trong một câu, và không có mối liên hệ rõ ràng nào giữa hai thứ đó. Đây là câu trả lời ngắn gọn: hãy kiểm tra bốn con số, theo thứ tự này. Cửa sổ ngữ cảnh và đầu ra tối đa quyết định liệu một mô hình có thể làm được nhiệm vụ của bạn hay không. Tốc độ và giá quyết định mức độ dễ chịu và độ tốn kém. Ngữ cảnh, giới hạn đầu ra và giá được liệt kê trên trang mô hình và trong bảng giá; tốc độ bạn tự kiểm tra trong khoảng một phút, và script ở bên dưới.
Bốn con số nói một cách đơn giản#
Hãy nghĩ về mô hình như một đồng nghiệp ngồi ở bàn làm việc. Cửa sổ ngữ cảnh là kích thước của bàn: mọi thứ phải ở trước mặt họ cùng một lúc. Đầu ra tối đa là họ có thể nói liên tục trong một lần được bao lâu. Tốc độ là họ bắt đầu trả lời nhanh đến mức nào. Giá là mức lương theo giờ của họ. Bốn thuật ngữ, và bạn sẽ gặp tất cả chúng trong mọi tài liệu API:
Thẻ ghi nhớ
Những từ bạn sẽ gặp trong mọi danh sách mô hình
Nhấn vào thẻ để lật
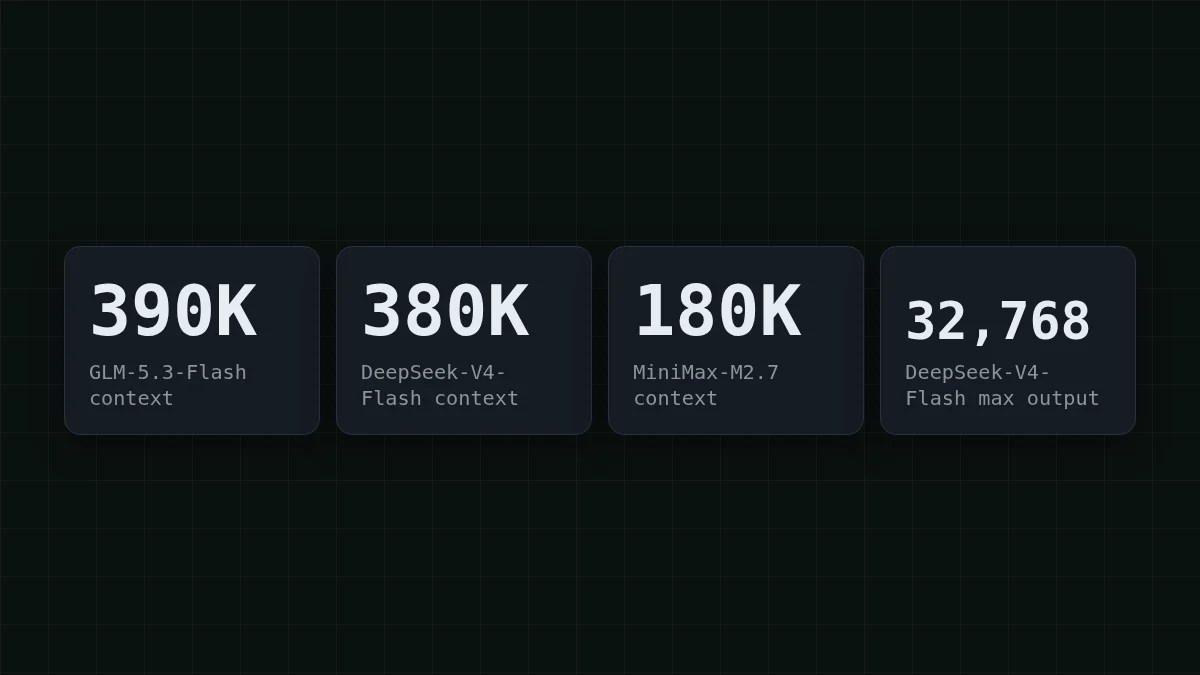
Để cụ thể hóa điều này, đây là hai con số đầu tiên cho ba mô hình trong danh mục CheapTokens, từ tài liệu tham khảo mô hình CheapTokens (27 tháng 10 năm 2026): GLM-5.3-Flash có ngữ cảnh 390K và trả lời tối đa 8.192 token; DeepSeek-V4-Flash (bản phát hành 0731) có 380K và trả lời tối đa 32.768 token; MiniMax-M2.7 có 180K và trả lời tối đa 8.192 token.
Ngữ cảnh: mọi thứ bạn gửi có vừa không?#
Giả sử trợ lý lập trình của bạn mở 12 tệp, mỗi tệp khoảng 3.000 token, sau đó thêm câu hỏi của bạn và ghi chú của chính nó. 12 × 3.000 = 36.000 token. Ngay cả cửa sổ nhỏ nhất ở trên, 180K, cũng chứa được lượng đó với rất nhiều chỗ trống. Một tệp khổng lồ duy nhất hoặc một bản kết xuất toàn bộ kho lưu trữ là lúc cửa sổ bắt đầu trở nên quan trọng.
Các cuộc trò chuyện và agent phức tạp hơn, vì API gửi lại toàn bộ lịch sử trong mỗi lần gọi. Lấy một agent chạy 20 bước, và mỗi bước thêm khoảng 2.000 token đầu ra công cụ và câu trả lời (một giả định cho ví dụ này). Bước 1 gửi 2.000 token, bước 2 gửi 4.000, bước 20 gửi 40.000. Trong toàn bộ lần chạy, nó gửi 2.000 × 210 = 420.000 token, trong đó 210 là 1 + 2 + … + 20.
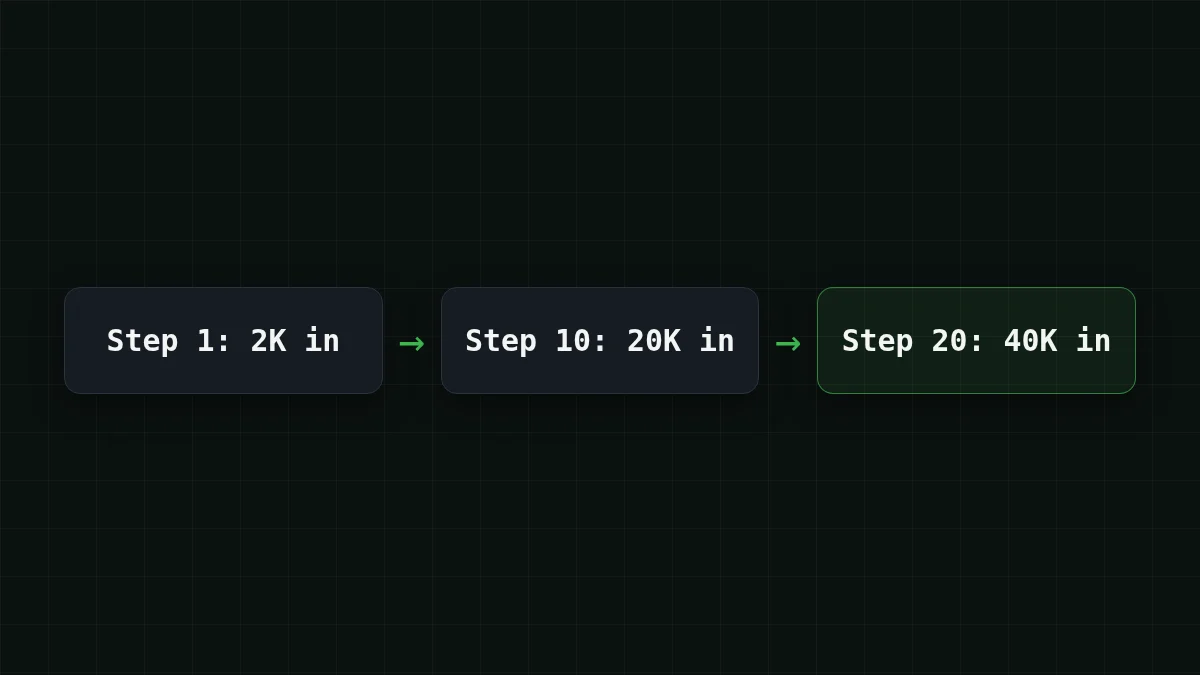
Hai câu hỏi khác nhau ẩn ở đây. Cửa sổ ngữ cảnh chỉ quan tâm đến yêu cầu đơn lẻ lớn nhất: 40.000 token ở bước 20, mà mọi mô hình trong danh mục đều chứa được dễ dàng. Hóa đơn quan tâm đến tổng cộng, 420.000 token. Hãy ghi nhớ cả hai, và bạn sẽ không chọn mô hình vì lý do sai.
Độ dài đầu ra: giới hạn cắt ngắn câu trả lời#
Giới hạn đầu ra là mức trần cho một câu trả lời, và rất dễ quên cho đến khi câu trả lời dừng giữa câu. Một quy tắc ngón tay cái cho tiếng Anh: một token khoảng ba phần tư một từ. Bạn yêu cầu một báo cáo 6000 từ: 6000 / 0.75 = 8000 token. Con số đó vừa khít dưới 8.192. Yêu cầu 7.000 từ và văn bản kết thúc giữa một đoạn.
Với mức trần 32.768 token, phép tính tương tự cho ra 24576 từ trong một câu trả lời (32768 × 0.75 = 24576), vì vậy mã được tạo, báo cáo dài và bản nháp của cả chương đều vừa trong một lần trả lời. Khi một câu trả lời bị cắt, API cho bạn biết: finish_reason trả về dưới dạng length (tại sao điều đó xảy ra và cách khắc phục).
Kiểm tra nhanh
Bạn yêu cầu một mô hình có giới hạn đầu ra 8.192 token viết một báo cáo 12.000 từ. Bạn nhận được gì?
Hiện đáp án
Trả lời: Một báo cáo dừng giữa chừng, với finish_reason được đặt thành length
12.000 từ khoảng 16.000 token, gấp đôi mức trần. Mô hình viết cho đến khi chạm trần và dừng lại, và API đánh dấu câu trả lời bằng finish_.
Tốc độ: con số duy nhất bạn tự đo#
Tốc độ thực ra là hai con số: mất bao lâu cho đến khi văn bản đầu tiên xuất hiện, và phần còn lại truyền về nhanh đến mức nào. Cả hai đều thay đổi theo tải, độ dài prompt và thời điểm trong ngày, nên một con số sao chép từ bảng là hướng dẫn kém. Hãy đo nó trên prompt của chính bạn. Việc này mất một phút và dùng vài token (khóa lấy từ một biến môi trường; xem tài liệu để tạo một khóa):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Bạn nhận được một dòng: first text after <N>s, finished after <M>s. Thay id mô hình bằng zai- hoặc MiniMaxAI/, chạy mỗi cái vài lần, và bạn có một so sánh tốc độ cho prompt của mình. Điều đó có quan trọng không? Với một cuộc trò chuyện trực tiếp, có: mọi người nhận thấy khoảng dừng trước từ đầu tiên. Với một lô tóm tắt chạy ban đêm, không ai theo dõi, và tốc độ rơi xuống cuối danh sách của bạn.
Giá: cộng đầu vào và đầu ra lại với nhau#
Giá được báo theo một triệu token, nhưng bạn trả tiền theo yêu cầu, và một yêu cầu có cả phía đầu vào lẫn phía đầu ra. Vì vậy hãy so sánh các mô hình trên một khối lượng công việc, không phải trên hai cột. Giả sử bot hỗ trợ của bạn xử lý 1.000 ticket mỗi ngày, mỗi ticket khoảng 300 token vào và 150 ra (một giả định; hãy thay bằng số của bạn). Bảng này là trực tiếp và tự tính lại từ giá hiện tại:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 token đầu vào và 150 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Hãy đọc tổng, không phải các cột. Tổng cộng, với đầu vào và đầu ra được tính cùng nhau, mỗi mô hình trong ba mô hình đều rẻ hơn giá tham chiếu của OpenRouter trong cột OpenRouter của bảng đó.
Và đây là lúc agent gây tốn kém. Lần chạy 20 bước từ phần ngữ cảnh gửi 420.000 token vào và viết ra có thể 4.000 token ra (200 mỗi bước, lại là một giả định). Trên DeepSeek-V4-Flash, một lần chạy như vậy tốn $0.0067. Năm lần chạy trong một ngày? Hãy di chuyển các thanh trượt và quan sát ba mô hình:
Máy tính chi phí
Một ngày làm việc của agent: năm nhiệm vụ 20 bước
Token đầu vào mỗi yêu cầu: 21.000 · Token đầu ra mỗi yêu cầu: 200 · Số yêu cầu mỗi ngày: 100
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Giá mô hình giữ nguyên ở bất kỳ giờ nào trong ngày, nên một phép tính bạn làm bây giờ cũng đúng cho lô chạy buổi tối. Để ôn lại lý do tại sao token đầu ra thường đắt hơn token đầu vào, xem token đầu vào và đầu ra.
Chọn mô hình theo nhiệm vụ#
Bắt đầu từ nhiệm vụ, tìm con số gây khó khăn nhất, và kiểm tra ba con số còn lại sau đó. Hãy nhấp qua trường hợp của chính bạn:
Chọn trường hợp của bạn
Mô hình nào cho nhiệm vụ của tôi?
Chọn một tùy chọn để xem đáp án
Bot hỗ trợ với câu trả lời ngắn
Câu hỏi và câu trả lời đều ngắn, nên mọi mô hình trong danh mục đều có chỗ dư, và cột giá quyết định. Hãy chạy ticket điển hình của bạn qua bảng chi phí ở trên và bắt đầu với GLM-5.3-Flash hoặc MiniMax-M2.7, tùy theo tổng nào trông tốt hơn với số của bạn.
Trợ lý lập trình đọc nhiều tệp
Ngữ cảnh đến trước. GLM-5.3-Flash có cửa sổ lớn nhất trong ba mô hình với 390K, DeepSeek-V4-Flash có 380K. MiniMax-M2.7 với 180K là đủ khi các tệp bạn gửi cùng nhau vẫn thấp hơn mức đó nhiều.
Agent lặp qua nhiều bước
Lịch sử được gửi lại ở mỗi bước, nên tổng tăng nhanh. DeepSeek-V4-Flash kết hợp ngữ cảnh 380K với tối đa 32.768 token đầu ra mỗi câu trả lời và một mức giá ở bất kỳ giờ nào, giúp các vòng lặp dài có thể dự đoán được. Hãy kiểm tra tổng bằng máy tính ở trên.
Báo cáo dài và mã được tạo
Đầu ra tối đa quyết định. DeepSeek-V4-Flash viết tối đa 32.768 token mỗi câu trả lời; GLM-5.3-Flash và MiniMax-M2.7 viết tối đa 8.192, đủ cho một báo cáo khoảng 6.000 từ.
Không có mô hình nào thắng mọi hàng, đó là lý do việc chạy cùng mười prompt thực tế qua hai ứng viên trước khi quyết định là hữu ích. So sánh GLM vs DeepSeek vs MiniMax đi sâu hơn về ba mô hình, và trang giá luôn hiển thị các con số hiện tại.


