AI для новичковИнструкция
Как выбрать модель ИИ: контекст, длина ответа, скорость, цена
Как выбрать модель для чата, кода или агента по четырём числам: контекст, длина ответа, скорость и цена. Примеры и живая таблица расходов.
Содержание
В списке сорок моделей, задача описана одной фразой, а связи между ними не видно. Короткий ответ: проверьте четыре числа и именно в таком порядке. Контекстное окно и максимальная длина ответа решают, справится ли модель с задачей вообще. Скорость и цена решают, насколько будет приятно и дорого. Контекст, лимит ответа и цена указаны на странице моделей и в таблице цен; скорость вы проверите сами минуты за полторы, скрипт ниже.
Четыре числа простыми словами#
Представьте модель как коллегу за столом. Контекстное окно — размер стола: всё, что должно лежать перед ним одновременно. Максимальный ответ — как долго он может говорить без перерыва. Скорость — как быстро он начинает отвечать. Цена — его почасовая ставка. Эти четыре термина встретятся вам в любой документации к API:
Карточки
Слова из любого списка моделей
Нажмите на карточку, чтобы перевернуть её
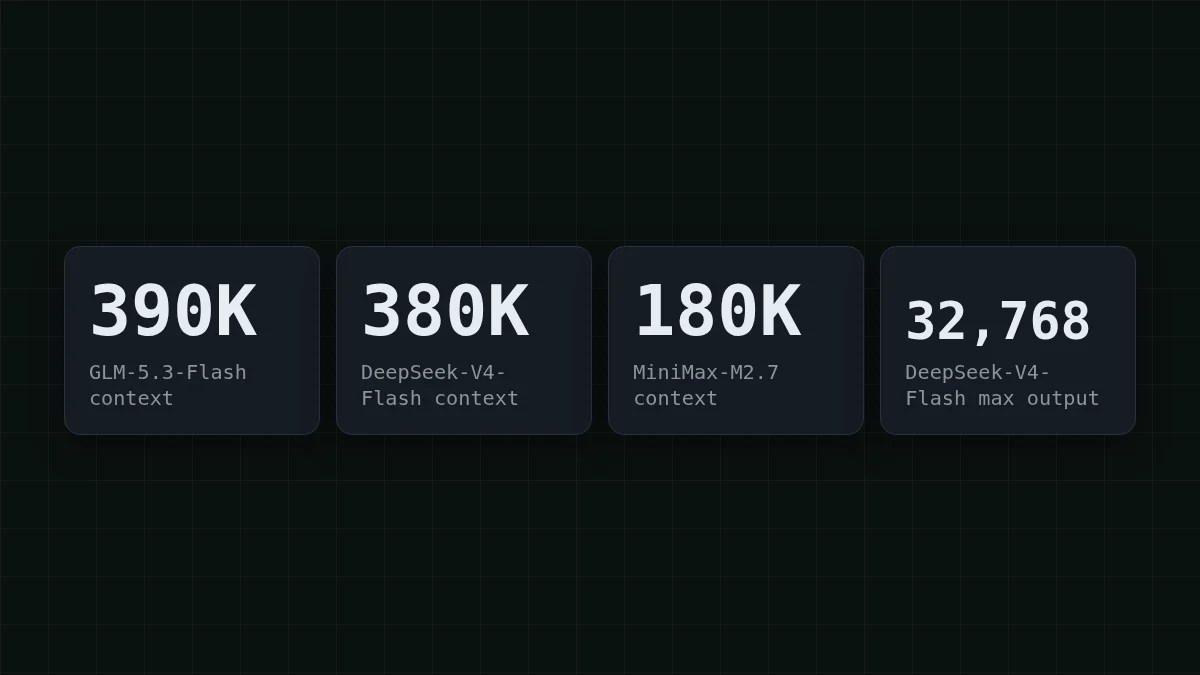
Для наглядности — первые два числа трёх моделей из каталога CheapTokens, по справке CheapTokens на 27 октября 2026 года: у GLM-5.3-Flash контекст 390K и ответ до 8 192 токенов; у DeepSeek-V4-Flash (выпуск 0731) контекст 380K и ответ до 32 768 токенов; у MiniMax-M2.7 контекст 180K и ответ до 8 192 токенов.
Контекст: поместится ли всё, что вы отправляете#
Допустим, ваш помощник по коду открывает 12 файлов примерно по 3 000 токенов, добавляет ваш вопрос и свои заметки. 12 × 3 000 = 36 000 токенов. Даже самое маленькое окно из списка, 180K, вмещает это с большим запасом. Один огромный файл или выгрузка целого репозитория — вот где окно начинает иметь значение.
Чаты и агенты хитрее: API отправляет всю историю заново при каждом вызове. Возьмём агента на 20 шагов, где каждый шаг добавляет около 2 000 токенов вывода инструментов и ответа (допущение для примера). На шаге 1 уходит 2 000 токенов, на шаге 2 — 4 000, на шаге 20 — 40 000. За весь прогон отправлено 2 000 × 210 = 420 000 токенов, где 210 — это 1 + 2 + … + 20.
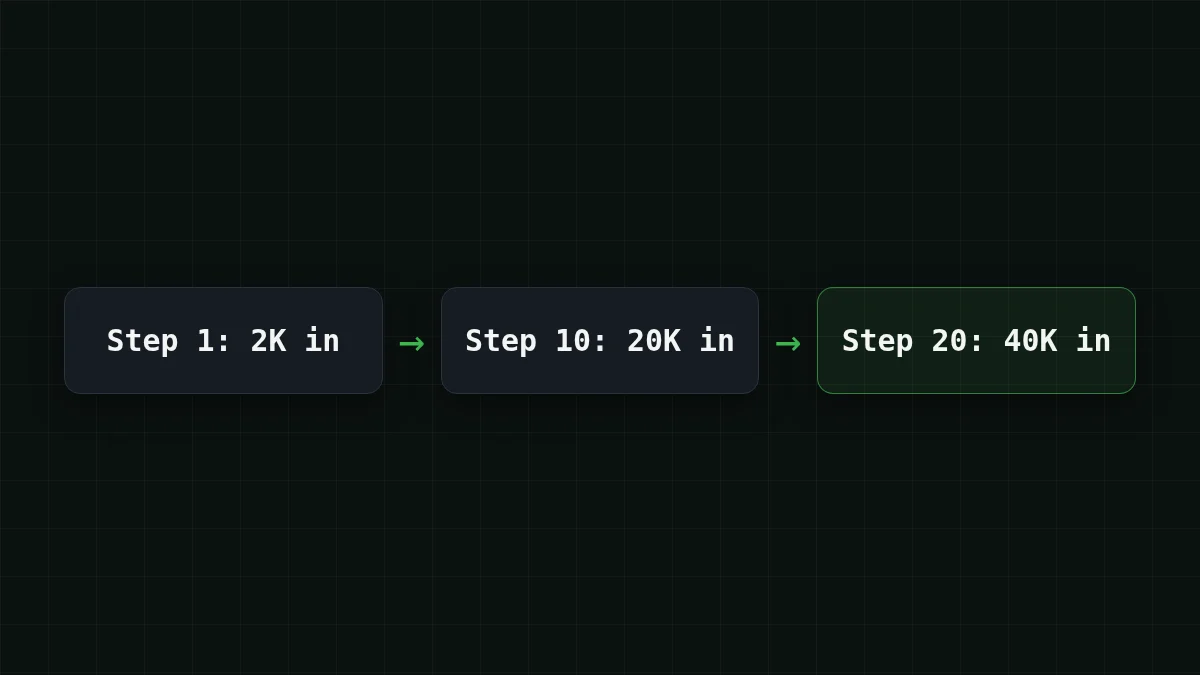
Здесь спрятаны два разных вопроса. Контекстное окно смотрит только на самый большой одиночный запрос: 40 000 токенов на шаге 20, и это легко вмещает любая модель каталога. Счёт смотрит на сумму — 420 000 токенов. Держите в голове оба, и модель вы выберете по правильной причине.
Длина ответа: лимит, который обрывает текст#
Лимит ответа — потолок на одну реплику, и о нём вспоминают, когда текст обрывается на полуслове. Правило для английского: один токен — примерно три четверти слова. Вы просите отчёт на 6 000 слов: 6000 / 0.75 = 8000 токенов. Это едва помещается под 8 192. Попросите 7 000 слов — и текст закончится посреди абзаца.
При потолке в 32 768 токенов та же арифметика даёт 24576 слов в одном ответе (32768 × 0.75 = 24576): сгенерированный код, длинные отчёты и черновики целых глав помещаются в одну реплику. Если ответ всё же обрезан, API сообщает об этом: finish_reason приходит со значением length (почему так бывает и как исправить).
Быстрая проверка
Вы просите у модели с лимитом ответа 8 192 токена отчёт на 12 000 слов. Что получите?
Показать ответ
Ответ: Отчёт, который оборвётся на середине, с finish_reason равным length
12 000 слов — это около 16 000 токенов, вдвое больше потолка. Модель пишет, пока не упрётся в предел, и останавливается, а API помечает ответ как finish_.
Скорость: число, которое проверяют сами#
Скорость — это на самом деле два числа: сколько ждать первого текста и как быстро идёт остальное. Оба зависят от нагрузки, длины промпта и времени суток, поэтому цифра из чужой таблицы — плохой ориентир. Замерьте на своём промпте. Это минута и несколько токенов (ключ берётся из переменной окружения, как его создать — в документации):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
На выходе одна строка: first text after <N>s, finished after <M>s. Замените id модели на zai- или MiniMaxAI/, запустите каждую несколько раз — и у вас есть сравнение скорости на вашем промпте. Важно ли это? Для живого чата да: пауза перед первым словом заметна. Для ночной пачки конспектов за экраном никто не сидит, и скорость уходит в конец списка.
Цена: считайте вход и выход вместе#
Цены называют за миллион токенов, но платите вы за запрос, а в запросе есть и вход, и выход. Поэтому сравнивайте модели на нагрузке, а не по двум колонкам. Допустим, ваш бот поддержки обрабатывает 1 000 обращений в день, в каждом около 300 токенов на входе и 150 на выходе (допущение, подставьте свои). Таблица живая и пересчитывается по текущим ценам:
| Модель | Вход $/1M | Выход $/1M | За запрос | 1 000 запросов | OpenRouter, 1 000 запросов |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 входных и 150 выходных токенов на запрос. Цены за 1M токенов актуальны и меняются вместе с нашими тарифами; столбец OpenRouter показывает справочные цены для той же нагрузки.
Смотрите на итог, а не на колонки. В сумме, с учётом входа и выхода, каждая из трёх моделей выходит дешевле референсной цены OpenRouter из колонки OpenRouter в этой таблице.
А вот агенты и кусаются. 20-шаговый прогон из раздела про контекст отправляет 420 000 токенов на вход и пишет, скажем, 4 000 на выход (по 200 за шаг, опять допущение). На DeepSeek-V4-Flash один такой прогон стоит $0.0067. Пять прогонов за день? Подвигайте ползунки и посмотрите на три модели:
Калькулятор стоимости
Рабочий день агента: пять 20-шаговых задач
Входные токены на запрос: 21 000 · Выходные токены на запрос: 200 · Запросов в день: 100
| Модель | В день | В месяц |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
Цены моделей одинаковы в любое время суток, поэтому расчёт, сделанный сейчас, верен и для вечерней пачки. Почему токены выхода обычно стоят дороже входа — в статье про входные и выходные токены.
Выбор модели под задачу#
Начните с задачи, найдите число, которое давит сильнее всего, и только потом проверьте остальные три. Прокликайте свой случай:
Выберите свой случай
Какая модель под мою задачу?
Выберите вариант, чтобы увидеть ответ
Бот поддержки с короткими ответами
Вопросы и ответы короткие, поэтому запаса хватает у любой модели каталога, и решает цена. Прогоните типичное обращение через таблицу расходов выше и начните с GLM-5.3-Flash или MiniMax-M2.7 — смотря у какой итог лучше на ваших числах.
Помощник по коду, который читает много файлов
Сначала контекст. У GLM-5.3-Flash самое большое окно из трёх, 390K, у DeepSeek-V4-Flash — 380K. MiniMax-M2.7 со 180K хватает, пока файлы, отправляемые вместе, остаются заметно ниже этого.
Агент, который крутится по многим шагам
История отправляется заново на каждом шаге, поэтому сумма растёт быстро. У DeepSeek-V4-Flash контекст 380K, ответ до 32 768 токенов и одна цена в любое время суток — длинные циклы остаются предсказуемыми. Итог проверьте калькулятором выше.
Длинные отчёты и генерация кода
Решает максимальный ответ. DeepSeek-V4-Flash пишет до 32 768 токенов за ответ; GLM-5.3-Flash и MiniMax-M2.7 — до 8 192, этого хватает на отчёт примерно в 6 000 слов.
Ни одна модель не выигрывает во всех строках, поэтому перед выбором полезно прогнать одни и те же десять настоящих промптов через двух кандидатов. Подробнее о трёх моделях — в сравнении GLM, DeepSeek и MiniMax, а актуальные числа всегда на странице цен.


