AI per principiantiGuida
Come scegliere un modello AI: contesto, output, velocità, prezzo
Scegli un modello per chat, programmazione o un agente con quattro numeri: finestra di contesto, output massimo, velocità e prezzo. Esempi pratici e una tabella dei costi live.
In questa pagina
Un elenco di modelli con quaranta nomi, un compito descritto in una frase e nessun collegamento ovvio tra i due. Ecco la risposta breve: controlla quattro numeri, in questo ordine. La finestra di contesto e l'output massimo decidono se un modello può svolgere il tuo compito. La velocità e il prezzo decidono quanto è piacevole e quanto costa. Contesto, limite di output e prezzo sono elencati nella pagina dei modelli e nella tabella dei prezzi; la velocità la misuri da solo in circa un minuto, e lo script è qui sotto.
I quattro numeri in parole semplici#
Immagina il modello come un collega alla scrivania. La finestra di contesto è la dimensione della scrivania: tutto ciò che deve avere davanti contemporaneamente. L'output massimo è quanto a lungo può parlare in un colpo solo. La velocità è quanto rapidamente inizia a rispondere. Il prezzo è la sua tariffa oraria. Quattro termini, e li incontrerai in ogni documentazione API:
Flashcard
Parole che incontrerai in ogni elenco di modelli
Tocca una carta per girarla
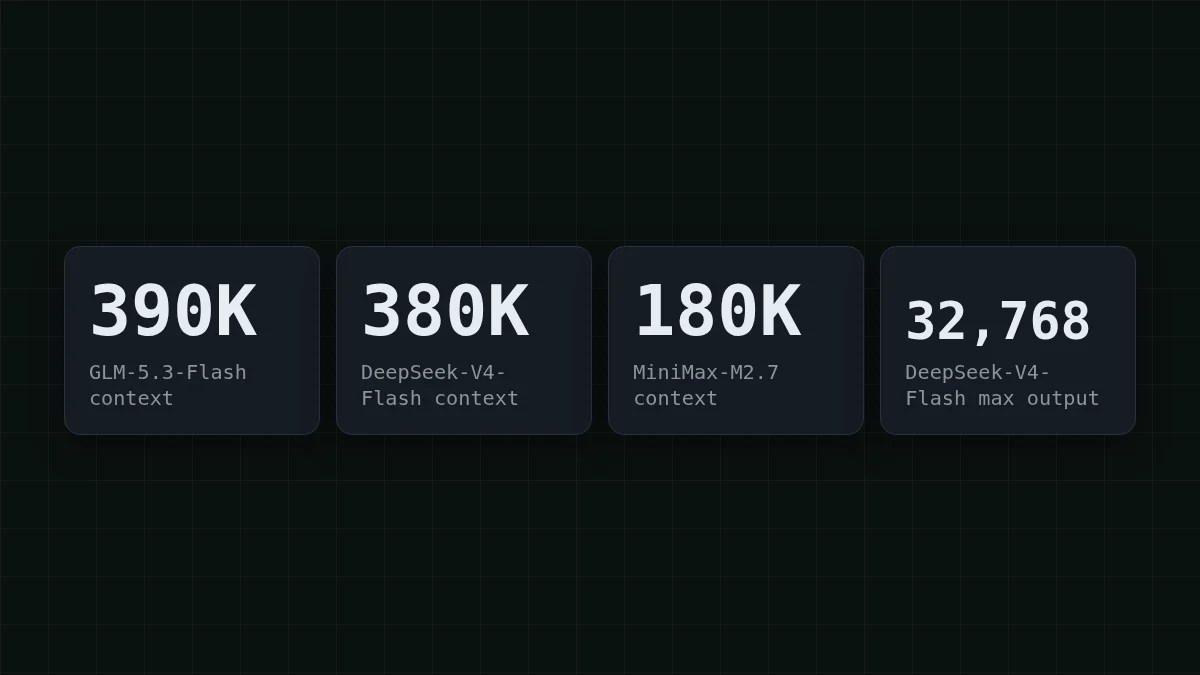
Per rendere tutto concreto, ecco i primi due numeri per i tre modelli nel catalogo CheapTokens, dalla documentazione dei modelli CheapTokens (27 ottobre 2026): GLM-5.3-Flash ha un contesto di 390K e risponde fino a 8.192 token; DeepSeek-V4-Flash (release 0731) ha 380K e risponde fino a 32.768 token; MiniMax-M2.7 ha 180K e risponde fino a 8.192 token.
Contesto: tutto ciò che invii entrerà?#
Supponiamo che il tuo assistente di programmazione apra 12 file di circa 3.000 token ciascuno, poi aggiunga la tua domanda e le sue note. 12 × 3.000 = 36.000 token. Anche la finestra più piccola qui sopra, 180K, lo contiene con ampio margine. Un singolo file enorme o un dump dell'intero repository è dove la finestra inizia a contare.
Chat e agenti sono più complicati, perché l'API rinvia l'intera cronologia a ogni chiamata. Prendi un agente che esegue 20 passaggi, e ogni passaggio aggiunge circa 2.000 token di output degli strumenti e risposta (un'ipotesi per questo esempio). Il passaggio 1 invia 2.000 token, il passaggio 2 ne invia 4.000, il passaggio 20 ne invia 40.000. Sull'intera esecuzione invia 2.000 × 210 = 420.000 token, dove 210 è 1 + 2 + … + 20.
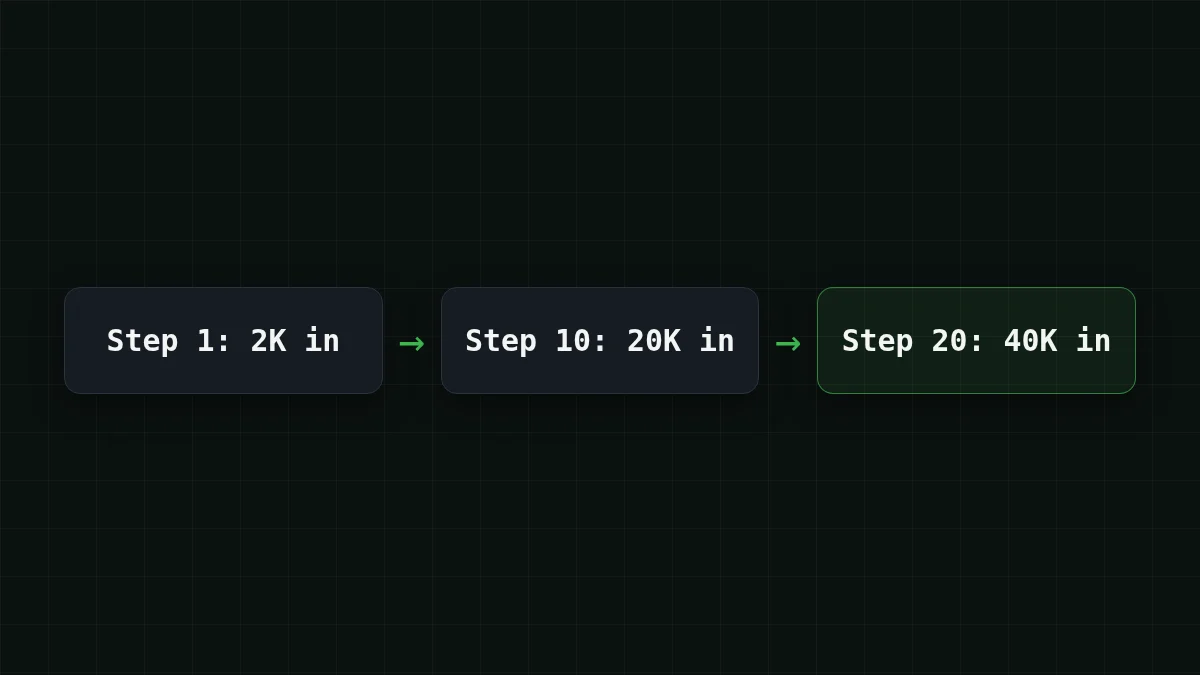
Qui si nascondono due domande diverse. La finestra di contesto si preoccupa solo della richiesta singola più grande: 40.000 token al passaggio 20, che ogni modello nel catalogo gestisce facilmente. Il conto si preoccupa del totale, 420.000 token. Tieni a mente entrambi, e non sceglierai un modello per il motivo sbagliato.
Lunghezza dell'output: il limite che tronca le risposte#
Il limite di output è un tetto su una singola risposta, ed è facile dimenticarlo finché una risposta non si interrompe a metà frase. Una regola empirica per l'inglese: un token è circa tre quarti di una parola. Chiedi un report di 6000 parole: 6000 / 0,75 = 8000 token. Entra appena sotto 8.192. Chiedi 7.000 parole e il testo finisce a metà paragrafo.
Con un tetto di 32.768 token la stessa aritmetica dà 24576 parole in una risposta (32768 × 0,75 = 24576), quindi codice generato, report lunghi e bozze di interi capitoli entrano in un singolo reply. Quando una risposta viene troncata, l'API te lo dice: finish_reason torna come length (perché succede e come risolverlo).
Verifica rapida
Chiedi a un modello con un limite di output di 8.192 token un report di 12.000 parole. Cosa ottieni?
Mostra risposta
Risposta: Un report che si interrompe a metà, con finish_reason impostato a length
12.000 parole sono circa 16.000 token, il doppio del tetto. Il modello scrive finché non raggiunge il tetto e si ferma, e l'API contrassegna la risposta con finish_.
Velocità: l'unico numero che misuri da solo#
La velocità è in realtà due numeri: quanto tempo passa prima che compaia il primo testo, e quanto velocemente scorre il resto. Entrambi variano con il carico, la lunghezza del prompt e l'ora del giorno, quindi una cifra copiata da una tabella è una guida scarsa. Misurala sul tuo prompt. Ci vuole un minuto e usa pochi token (la chiave viene da una variabile d'ambiente; vedi la documentazione per crearne una):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
Ottieni una riga: first text after <N>s, finished after <M>s. Sostituisci l'id del modello con zai- o MiniMaxAI/, esegui ciascuno alcune volte, e hai un confronto di velocità per il tuo prompt. Conta? Per una chat dal vivo, sì: le persone notano una pausa prima della prima parola. Per un batch notturno di riassunti, nessuno guarda, e la velocità scende in fondo alla tua lista.
Prezzo: somma input e output insieme#
I prezzi sono indicati per milione di token, ma paghi per richiesta, e una richiesta ha sia un lato input che un lato output. Quindi confronta i modelli su un carico di lavoro, non su due colonne. Supponiamo che il tuo bot di supporto gestisca 1.000 ticket al giorno, ciascuno di circa 300 token in input e 150 in output (un'ipotesi; sostituiscila con la tua). La tabella è live e si ricalcola dai prezzi attuali:
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
300 token di input e 150 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Leggi il totale, non le colonne. In totale, con input e output contati insieme, ciascuno dei tre risulta più economico del prezzo di riferimento di OpenRouter nella colonna OpenRouter di quella tabella.
E qui è dove gli agenti mordono. L'esecuzione di 20 passaggi della sezione sul contesto invia 420.000 token in input e ne scrive forse 4.000 in output (200 per passaggio, ancora un'ipotesi). Su DeepSeek-V4-Flash una tale esecuzione costa $0.0067. Cinque esecuzioni in un giorno? Muovi gli slider e osserva i tre modelli:
Calcolatore di costi
Una giornata di lavoro di un agente: cinque compiti di 20 passaggi
Token di input per richiesta: 21.000 · Token di output per richiesta: 200 · Richieste al giorno: 100
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
I prezzi dei modelli restano gli stessi a qualsiasi ora del giorno, quindi un calcolo che fai ora vale anche per il batch serale. Per un ripasso sul perché i token di output di solito costano più di quelli di input, vedi token di input e output.
Scegli un modello in base al compito#
Parti dal compito, trova il numero che morde di più, e controlla gli altri tre dopo. Clicca sul tuo caso:
Scegli il tuo caso
Quale modello per il mio compito?
Scegli un'opzione per vedere la risposta
Un bot di supporto con risposte brevi
Domande e risposte sono brevi, quindi ogni modello nel catalogo ha spazio in abbondanza, e la colonna del prezzo decide. Fai passare il tuo ticket tipico nella tabella dei costi qui sopra e inizia con GLM-5.3-Flash o MiniMax-M2.7, qualunque totale sembri migliore per i tuoi numeri.
Un assistente di programmazione che legge molti file
Il contesto viene prima. GLM-5.3-Flash ha la finestra più grande dei tre a 390K, DeepSeek-V4-Flash ha 380K. MiniMax-M2.7 a 180K è sufficiente quando i file che invii insieme restano ben sotto quella soglia.
Un agente che itera su molti passaggi
La cronologia viene rinviata a ogni passaggio, quindi il totale cresce in fretta. DeepSeek-V4-Flash combina un contesto di 380K con fino a 32.768 token di output per risposta e un prezzo unico a qualsiasi ora, il che mantiene prevedibili i cicli lunghi. Controlla il totale con il calcolatore qui sopra.
Report lunghi e codice generato
L'output massimo decide. DeepSeek-V4-Flash scrive fino a 32.768 token per risposta; GLM-5.3-Flash e MiniMax-M2.7 scrivono fino a 8.192, che copre un report di circa 6.000 parole.
Nessun singolo modello vince su ogni riga, ed è per questo che conviene far passare gli stessi dieci prompt reali attraverso due candidati prima di impegnarti. Il confronto GLM vs DeepSeek vs MiniMax approfondisce i tre modelli, e la pagina dei prezzi mostra sempre i numeri attuali.


