কীভাবে একটি AI মডেল বেছে নেবেন: কনটেক্সট, আউটপুট, গতি, মূল্য
চারটি সংখ্যা দিয়ে চ্যাট, কোডিং বা এজেন্টের জন্য একটি মডেল বেছে নিন: কনটেক্সট উইন্ডো, সর্বোচ্চ আউটপুট, গতি এবং মূল্য। কার্যকর উদাহরণ এবং একটি লাইভ খরচ টেবিল।
এই পৃষ্ঠায়
চল্লিশটি নামের একটি মডেল তালিকা, এক বাক্যে বর্ণিত একটি কাজ, এবং দুটির মধ্যে কোনো স্পষ্ট সংযোগ নেই। সংক্ষিপ্ত উত্তর হলো: চারটি সংখ্যা পরীক্ষা করুন, এই ক্রমে। কনটেক্সট উইন্ডো এবং সর্বোচ্চ আউটপুট নির্ধারণ করে একটি মডেল আদৌ আপনার কাজ করতে পারবে কি না। গতি এবং মূল্য নির্ধারণ করে এটি কতটা আরামদায়ক এবং কতটা ব্যয়বহুল। কনটেক্সট, আউটপুট সীমা এবং মূল্য মডেল পেজে এবং প্রাইসিং টেবিলে তালিকাভুক্ত আছে; গতি আপনি নিজেই প্রায় এক মিনিটে পরীক্ষা করতে পারেন, এবং স্ক্রিপ্টটি নিচে দেওয়া আছে।
চারটি সংখ্যা সহজ ভাষায়#
মডেলটিকে একজন সহকর্মী হিসেবে ভাবুন যিনি একটি ডেস্কে বসে আছেন। কনটেক্সট উইন্ডো হলো ডেস্কের আকার: একসাথে তাদের সামনে যা কিছু থাকতে হবে তার সবকিছু। সর্বোচ্চ আউটপুট হলো তারা একবারে কতক্ষণ কথা বলতে পারে। গতি হলো তারা কত দ্রুত উত্তর দিতে শুরু করে। মূল্য হলো তাদের ঘণ্টাপ্রতি হার। চারটি শব্দ, এবং আপনি প্রতিটি API ডকে এগুলো দেখতে পাবেন:
ফ্ল্যাশকার্ড
প্রতিটি মডেল তালিকায় যে শব্দগুলো দেখবেন
উল্টাতে কার্ডে ট্যাপ করুন
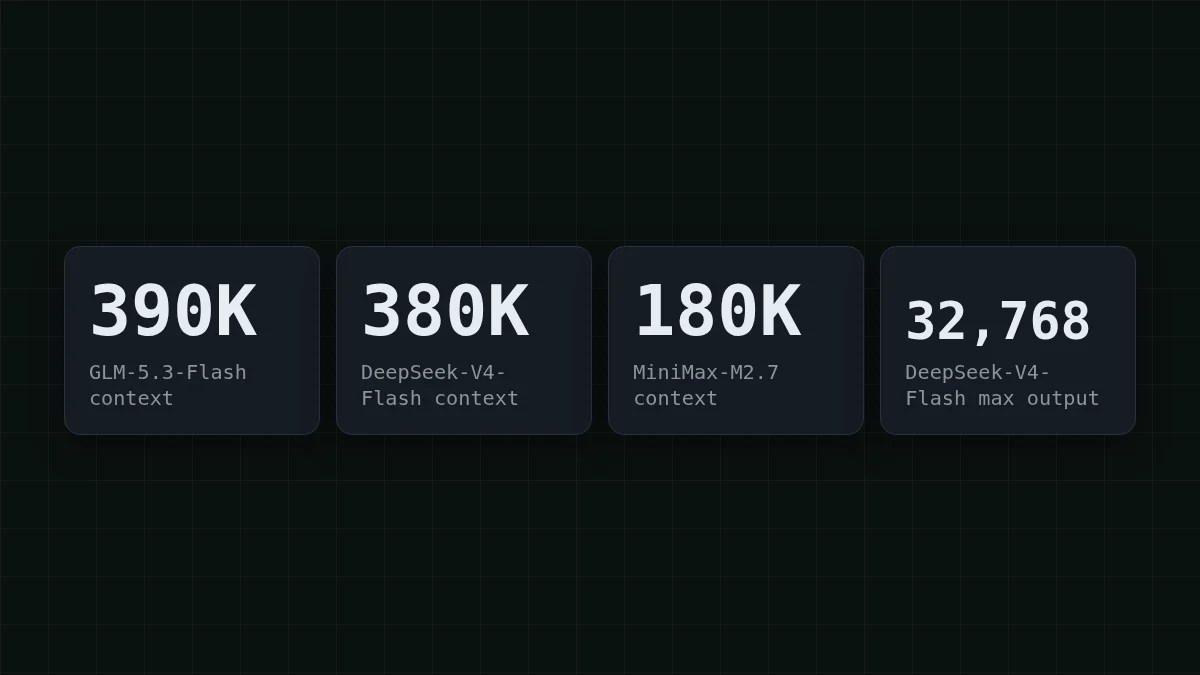
এটি বাস্তবসম্মত করতে, CheapTokens ক্যাটালগের তিনটি মডেলের প্রথম দুটি সংখ্যা এখানে দেওয়া হলো, CheapTokens মডেল রেফারেন্স (২৭ অক্টোবর ২০২৬) থেকে: GLM-5.3-Flash-এর 390K কনটেক্সট আছে এবং 8,192 টোকেন পর্যন্ত উত্তর দেয়; DeepSeek-V4-Flash (রিলিজ 0731)-এর 380K আছে এবং 32,768 টোকেন পর্যন্ত উত্তর দেয়; MiniMax-M2.7-এর 180K আছে এবং 8,192 টোকেন পর্যন্ত উত্তর দেয়।
কনটেক্সট: আপনার পাঠানো সবকিছু কি ফিট করবে?#
ধরুন আপনার কোডিং অ্যাসিস্ট্যান্ট প্রায় 3,000 টোকেনের 12টি ফাইল খোলে, তারপর আপনার প্রশ্ন এবং তার নিজের নোট যোগ করে। 12 × 3,000 = 36,000 টোকেন। উপরের সবচেয়ে ছোট উইন্ডো, 180K, যথেষ্ট জায়গাসহ এটি ধরে রাখে। একটি একক বিশাল ফাইল বা একটি সম্পূর্ণ রিপোজিটরি ডাম্প হলো যেখানে উইন্ডোটি গুরুত্বপূর্ণ হতে শুরু করে।
চ্যাট এবং এজেন্টরা আরও জটিল, কারণ API প্রতিটি কলে সম্পূর্ণ ইতিহাস পুনরায় পাঠায়। ধরুন একটি এজেন্ট 20টি ধাপ চালায়, এবং প্রতিটি ধাপ প্রায় 2,000 টোকেন টুল আউটপুট এবং উত্তর যোগ করে (এই উদাহরণের জন্য একটি অনুমান)। ধাপ 1 পাঠায় 2,000 টোকেন, ধাপ 2 পাঠায় 4,000, ধাপ 20 পাঠায় 40,000। পুরো রান জুড়ে এটি পাঠায় 2,000 × 210 = 420,000 টোকেন, যেখানে 210 হলো 1 + 2 + … + 20।
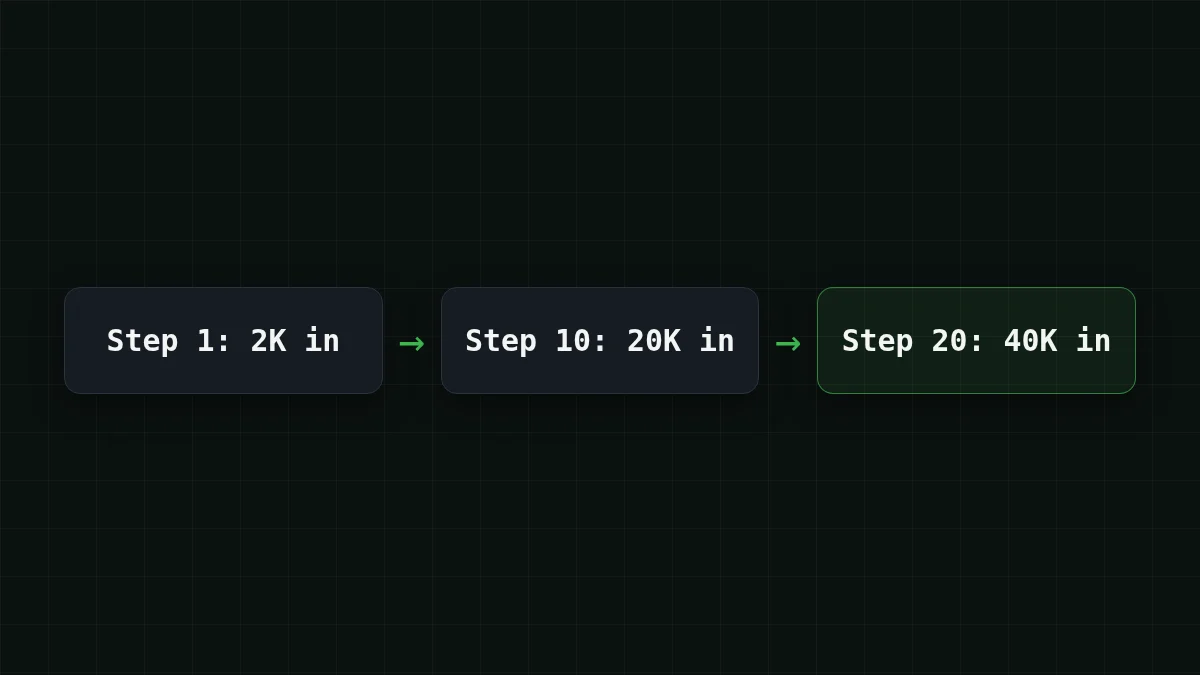
এখানে দুটি ভিন্ন প্রশ্ন লুকিয়ে আছে। কনটেক্সট উইন্ডো শুধুমাত্র সবচেয়ে বড় একক অনুরোধের বিষয়ে চিন্তা করে: ধাপ 20-এ 40,000 টোকেন, যা ক্যাটালগের প্রতিটি মডেল সহজেই ধরে রাখে। বিল মোটের বিষয়ে চিন্তা করে, 420,000 টোকেন। দুটোই মনে রাখুন, এবং আপনি ভুল কারণে একটি মডেল বেছে নেবেন না।
আউটপুট দৈর্ঘ্য: যে সীমা উত্তর ছোট করে কেটে দেয়#
আউটপুট সীমা একটি উত্তরের উপর একটি সিলিং, এবং একটি উত্তর মাঝ-বাক্যে থামার আগ পর্যন্ত এটি ভুলে যাওয়া সহজ। ইংরেজির জন্য একটি নিয়ম: একটি টোকেন প্রায় একটি শব্দের তিন-চতুর্থাংশ। আপনি 6000 শব্দের একটি রিপোর্ট চান: 6000 / 0.75 = 8000 টোকেন। এটি ঠিক 8,192-এর নিচে ফিট করে। 7,000 শব্দ চাইলে টেক্সট একটি অনুচ্ছেদের মাঝখানে শেষ হয়।
32,768-টোকেন সিলিং দিয়ে একই গণিত একটি উত্তরে 24576 শব্দে দাঁড়ায় (32768 × 0.75 = 24576), তাই জেনারেট করা কোড, দীর্ঘ রিপোর্ট এবং সম্পূর্ণ অধ্যায়ের খসড়া একটি একক উত্তরে ফিট করে। যখন একটি উত্তর সত্যিই কেটে যায়, API আপনাকে জানায়: finish_reason ফেরত আসে length হিসেবে (কেন এটি ঘটে এবং কীভাবে ঠিক করবেন)।
দ্রুত যাচাই
আপনি 8,192-টোকেন আউটপুট সীমার একটি মডেলের কাছে 12,000-শব্দের একটি রিপোর্ট চান। আপনি কী পান?
উত্তর দেখান
উত্তর: একটি রিপোর্ট যা মাঝপথে থামে, finish_reason length-এ সেট থাকে
12,000 শব্দ প্রায় 16,000 টোকেন, সীমার দ্বিগুণ। মডেল সিলিং-এ পৌঁছানো পর্যন্ত লেখে এবং থামে, এবং API উত্তরটি finish_ দিয়ে চিহ্নিত করে।
গতি: যে একটি সংখ্যা আপনি নিজেই মাপেন#
গতি আসলে দুটি সংখ্যা: প্রথম টেক্সট আসতে কত সময় লাগে, এবং বাকিটা কত দ্রুত স্ট্রিম করে। দুটোই লোড, প্রম্পট দৈর্ঘ্য এবং দিনের সময়ের সাথে পরিবর্তিত হয়, তাই একটি টেবিল থেকে কপি করা সংখ্যা একটি দুর্বল নির্দেশিকা। এটি আপনার নিজের প্রম্পটে মাপুন। এটি এক মিনিট সময় নেয় এবং কয়েকটি টোকেন ব্যবহার করে (কীটি একটি এনভায়রনমেন্ট ভেরিয়েবল থেকে আসে; একটি তৈরি করার জন্য ডক্স দেখুন):
import os, time
from openai import OpenAI

client = OpenAI(
    base_url="https://api.cheaptokens.dev/v1",
    api_key=os.environ["CHEAPTOKENS_API_KEY"],
)

start = time.perf_counter()
first = None
stream = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4-Flash-0731",
    messages=[{"role": "user", "content": "Explain what a token is in 3 sentences."}],
    stream=True,
)
for chunk in stream:
    if first is None and chunk.choices and chunk.choices[0].delta.content:
        first = time.perf_counter() - start
total = time.perf_counter() - start
print(f"first text after {first:.1f}s, finished after {total:.1f}s")
আপনি একটি লাইন পান: first text after <N>s, finished after <M>s। মডেল আইডিটি zai- বা MiniMaxAI/ দিয়ে বদলান, প্রতিটি কয়েকবার চালান, এবং আপনার প্রম্পটের জন্য একটি গতির তুলনা পাবেন। এটি কি গুরুত্বপূর্ণ? একটি লাইভ চ্যাটের জন্য, হ্যাঁ: মানুষ প্রথম শব্দের আগে একটি বিরতি লক্ষ্য করে। সারসংক্ষেপের একটি রাতের ব্যাচের জন্য, কেউ দেখছে না, এবং গতি আপনার তালিকার নিচে নেমে যায়।
মূল্য: ইনপুট এবং আউটপুট একসাথে যোগ করুন#
মূল্য প্রতি মিলিয়ন টোকেনে উদ্ধৃত হয়, কিন্তু আপনি প্রতি অনুরোধে পরিশোধ করেন, এবং একটি অনুরোধের একটি ইনপুট দিক এবং একটি আউটপুট দিক উভয়ই থাকে। তাই দুটি কলামে নয়, একটি ওয়ার্কলোডে মডেল তুলনা করুন। ধরুন আপনার সাপোর্ট বট দিনে 1,000 টিকিট হ্যান্ডেল করে, প্রতিটি প্রায় 300 টোকেন ইন এবং 150 আউট (একটি অনুমান; এটি আপনার নিজের দিয়ে প্রতিস্থাপন করুন)। টেবিলটি লাইভ এবং বর্তমান মূল্য থেকে পুনরায় গণনা করে:
| মডেল | ইনপুট $/১ মিলিয়ন | আউটপুট $/১ মিলিয়ন | প্রতি অনুরোধে | ১,০০০টি অনুরোধ | OpenRouter, ১,০০০টি অনুরোধ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0238 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.0378 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.27 |
প্রতি অনুরোধে ৩০০ ইনপুট এবং ১৫০ আউটপুট টোকেন। প্রতি 1M টোকেনের দাম বর্তমান এবং আমাদের ট্যারিফের সাথে পরিবর্তিত হয়; OpenRouter কলামটি একই ওয়ার্কলোডের জন্য রেফারেন্স মূল্য দেখায়।
কলাম নয়, মোট পড়ুন। মোটে, ইনপুট এবং আউটপুট একসাথে গণনা করে, তিনটির প্রত্যেকটি সেই টেবিলের OpenRouter কলামে OpenRouter-এর রেফারেন্স মূল্যের চেয়ে সস্তা হয়।
এবং এখানেই এজেন্টরা কামড় দেয়। কনটেক্সট বিভাগের 20-ধাপের রান 420,000 টোকেন ইন পাঠায় এবং সম্ভবত 4,000 আউট লেখে (প্রতি ধাপে 200, আবার একটি অনুমান)। DeepSeek-V4-Flash-এ এমন একটি রানের খরচ $0.0067। দিনে পাঁচটি রান? স্লাইডারগুলো সরান এবং তিনটি মডেল দেখুন:
খরচ ক্যালকুলেটর
এজেন্ট কাজের একটি দিন: পাঁচটি 20-ধাপের কাজ
প্রতি অনুরোধে ইনপুট টোকেন: ২১,০০০ · প্রতি অনুরোধে আউটপুট টোকেন: ২০০ · প্রতিদিন অনুরোধ: ১০০
| মডেল | প্রতিদিন | প্রতি মাসে |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.0428 | $1.28 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.0335 | $1.01 |
| MiniMax-M2.7$0.05$0.15 | $0.108 | $3.24 |
মডেলের মূল্য দিনের যেকোনো সময় একই থাকে, তাই এখন আপনি যে গণনা করবেন তা সন্ধ্যার ব্যাচের জন্যও প্রযোজ্য। আউটপুট টোকেন সাধারণত ইনপুটের চেয়ে বেশি খরচ করে কেন তার একটি রিফ্রেশারের জন্য, ইনপুট এবং আউটপুট টোকেন দেখুন।
কাজ অনুযায়ী একটি মডেল বেছে নিন#
কাজ থেকে শুরু করুন, যে সংখ্যাটি সবচেয়ে কঠিনভাবে কামড় দেয় তা খুঁজুন, এবং পরে বাকি তিনটি পরীক্ষা করুন। আপনার নিজের কেসে ক্লিক করুন:
আপনার কেস বেছে নিন
আমার কাজের জন্য কোন মডেল?
উত্তর দেখতে একটি বিকল্প বেছে নিন
সংক্ষিপ্ত উত্তরসহ একটি সাপোর্ট বট
প্রশ্ন এবং উত্তর সংক্ষিপ্ত, তাই ক্যাটালগের প্রতিটি মডেলের যথেষ্ট জায়গা আছে, এবং মূল্য কলাম সিদ্ধান্ত নেয়। আপনার সাধারণ টিকিট উপরের খরচ টেবিলের মাধ্যমে চালান এবং GLM-5.3-Flash বা MiniMax-M2.7 দিয়ে শুরু করুন, আপনার সংখ্যার জন্য যেটির মোট ভালো দেখায়।
একটি কোডিং অ্যাসিস্ট্যান্ট যা অনেক ফাইল পড়ে
কনটেক্সট প্রথমে আসে। GLM-5.3-Flash-এর তিনটির মধ্যে সবচেয়ে বড় উইন্ডো 390K, DeepSeek-V4-Flash-এর 380K। MiniMax-M2.7-এর 180K যথেষ্ট যখন আপনি একসাথে পাঠানো ফাইলগুলো সেই সীমার অনেক নিচে থাকে।
একটি এজেন্ট যা অনেক ধাপ লুপ করে
প্রতিটি ধাপে ইতিহাস পুনরায় পাঠানো হয়, তাই মোট দ্রুত বাড়ে। DeepSeek-V4-Flash একটি 380K কনটেক্সটের সাথে প্রতি উত্তরে 32,768 আউটপুট টোকেন পর্যন্ত এবং যেকোনো সময়ে একই মূল্য একত্রিত করে, যা দীর্ঘ লুপগুলোকে পূর্বানুমেয় রাখে। উপরের ক্যালকুলেটর দিয়ে মোট পরীক্ষা করুন।
দীর্ঘ রিপোর্ট এবং জেনারেট করা কোড
সর্বোচ্চ আউটপুট সিদ্ধান্ত নেয়। DeepSeek-V4-Flash প্রতি উত্তরে 32,768 টোকেন পর্যন্ত লেখে; GLM-5.3-Flash এবং MiniMax-M2.7 8,192 পর্যন্ত লেখে, যা প্রায় 6,000 শব্দের একটি রিপোর্ট কভার করে।
কোনো একক মডেল প্রতিটি সারিতে জয়ী হয় না, তাই প্রতিশ্রুতিবদ্ধ হওয়ার আগে একই দশটি বাস্তব প্রম্পট দুটি প্রার্থীর মাধ্যমে চালানো সহায়ক। GLM vs DeepSeek vs MiniMax তুলনা তিনটি মডেলের উপর আরও গভীরে যায়, এবং প্রাইসিং পেজ সর্বদা বর্তমান সংখ্যা দেখায়।


